搜索引擎的一部“历史”:绘制记忆、学习与发现技术的关系图
这个段落位置已不存在。请使用目录或当前章节查找内容。
Rosie Graham
搜索引擎的一部“历史”:绘制记忆、学习与发现技术的关系图
Rosie Graham
我们能否画出一条时间线,把搜索引擎安放其中?这是个既平常又奇怪的问题。我们不断把技术放进语境,将新与旧联系起来,并对照相似与相异之处;我们在使用中不自觉地这样做,而这使我们觉得自己理解了某些现象。例如,我们大多数人都隐约知道钟表的历史。佩戴手表的人即使没有有意识地研究这段历史,也可能把自己的数字腕表放进一个家谱,其源头可追溯到日晷、水钟、沙漏、蜡烛钟、摆钟、怀表和石英表。在这个例子中,发展时间线很容易画出来。机械运作过程可能大不相同,但现代钟表的祖先都服务于非常相似的目的。物质细节的精密程度随时间变化,这意味着为现代奥运会设计的计时装置与日晷所承担的工作差别很大,但它们都是同一种追求的表现。无论计时器使用沙、水还是石英晶体,这类时间线都可称为意图的谱系。
我们可以用许多不同的方法,在历史中理解技术。第二种方法可以称为机器的谱系。从这一角度看,我们不把现代数字手表放进包含其他计时器的家谱,而可能将其与其他数字设备联系起来。因此,我们可能不顾功能差异,便自然地把数字手表与其他数字技术相联。这种方法有助于思考某些技术是何时发明的,也涉及构成我们历史过去的社会与历史网络。“石器时代”和“青铜时代”这两个词暗含着一种做法:我们根据物理材料和机器,而非较抽象的意图和目标,来构建时间线与历史地图。我们还有许多其他方法,把现象与技术放入历史谱系;其中不少是我们在心中不自觉地借用和建构的,它们可以加深我们对当代技术与行为的理解。
面对 Google 属于哪一种谱系的问题,许多人可能想起 Ask Jeeves、AltaVista,或者把这个网站与其他网络导航方式相联系。然而,关于网络搜索引擎的谱系,以及这种技术整体适合放入什么语境,较为宽泛的问题要棘手得多。本文不打算用一条全面的时间线来回答这个问题,把搜索引擎整齐地安放其中; 而是提出,思考时间线、谱系和关系网络的过程,比建构一棵以网络搜索引擎为最新后代的单一家谱更有用。我将介绍若干例子,它们与我们理解搜索引擎的方式有关。我不会把它们过分整齐地捆在一起,而会尝试提出比答案更多的问题。
考虑到互联网、万维网和搜索引擎在我们生活中的普及程度,我们似乎还没有发展出谈论它们的恰当语言。当我向亲友谈论自己日常研究搜索引擎的活动,而我们使用的词语反倒成为障碍而非帮助时,这种感受尤为强烈。“互联网是一种媒介吗?网络是一个平台吗?搜索引擎是工具吗?还是仅仅是网站?媒介?目录?”大多数时候,人们认为这些问题与普通用户无关,因而回避或忽略它们。用户无需理解互联网与万维网的区别,就可以发送电子邮件。要查出巴拉克·奥巴马的出生年份或他就任总统的日期,用户也不必知道搜索引擎如何运作。当我们的工具运转正常时,准确的语言或专业知识可能显得并不重要。当预期、意图与结果彼此一致时,对技术更深入的理解,以及讨论它的词汇,就退到了背景之中。
然而,当人们对搜索引擎及其对用户的影响表示担忧时,这些隐含的预期就会变得更突出。有人高呼隐私受到侵犯,有人担心搜索引擎改变知识的价值或注意力持续时间,有人害怕它们提供忽视文化差异的主导性同质视角;又或者,相反,有人担心它们制造过滤气泡,机械地向用户反馈搜索结果,这些结果过于贴合其搜索行为,以至于用户无法接触可用于质疑自身价值观的新视角。当我们使用搜索引擎的体验与预期不一致时,这些以及许多其他忧虑便会出现。这些预期从何而来,是一个复杂的问题。预期的一个要素,是技术、思想和制度所确立的历史先例:用户暗中将它们组成一棵家谱或一条谱系,而搜索引擎是其最新化身。但我要论证,当用户理解一种现象时,关于曾直接影响当下技术的前代技术与制度的知识,并不是这一过程最突出的因素。更重要的是我们的隐性映射过程:把自己觉得相似或互补的事例联系起来,不论其他技术或制度是否与眼前现象的存在及身份有直接影响或关系。因此,决定技术如何被使用,也决定我们认为它应当如何运作的,是每个人流动的、临时形成的语境。
搜索引擎不符合一种既定的技术类型——它们不只是网站、媒介、工具、平台、网络或服务——因此,把它们与历史事例比较,考察它们在更广阔历史发展中的位置,对于理解我们作为用户暗中认为搜索引擎是什么、应当具备什么能力,十分重要。然而,实际的历史发展并非线性的,而我们也往往不那样思考。相反,我们对相关现象的知识构成一片关联星座。这种根茎式思考引出多种彼此重叠、常常相互矛盾的历史,它们构成 我们对搜索引擎的认识的重要部分。因此,我要主张,要更深入地理解搜索引擎及其历史,可以摆脱整齐的家谱,转向以非线性方式理解关联。我们理解搜索引擎与其他技术和行为之间关系的方式,更像是在夜空中构造星座。我们注视星星,根据对我们有意义的叙事来描画它们的相互关联,而不是准确说明这些天体实际上如何聚合。有意识地勾勒出我们将搜索引擎置于语境中的不同方式,有助于理解那些隐含而临时的定义;而这些定义反过来塑造我们的行为。
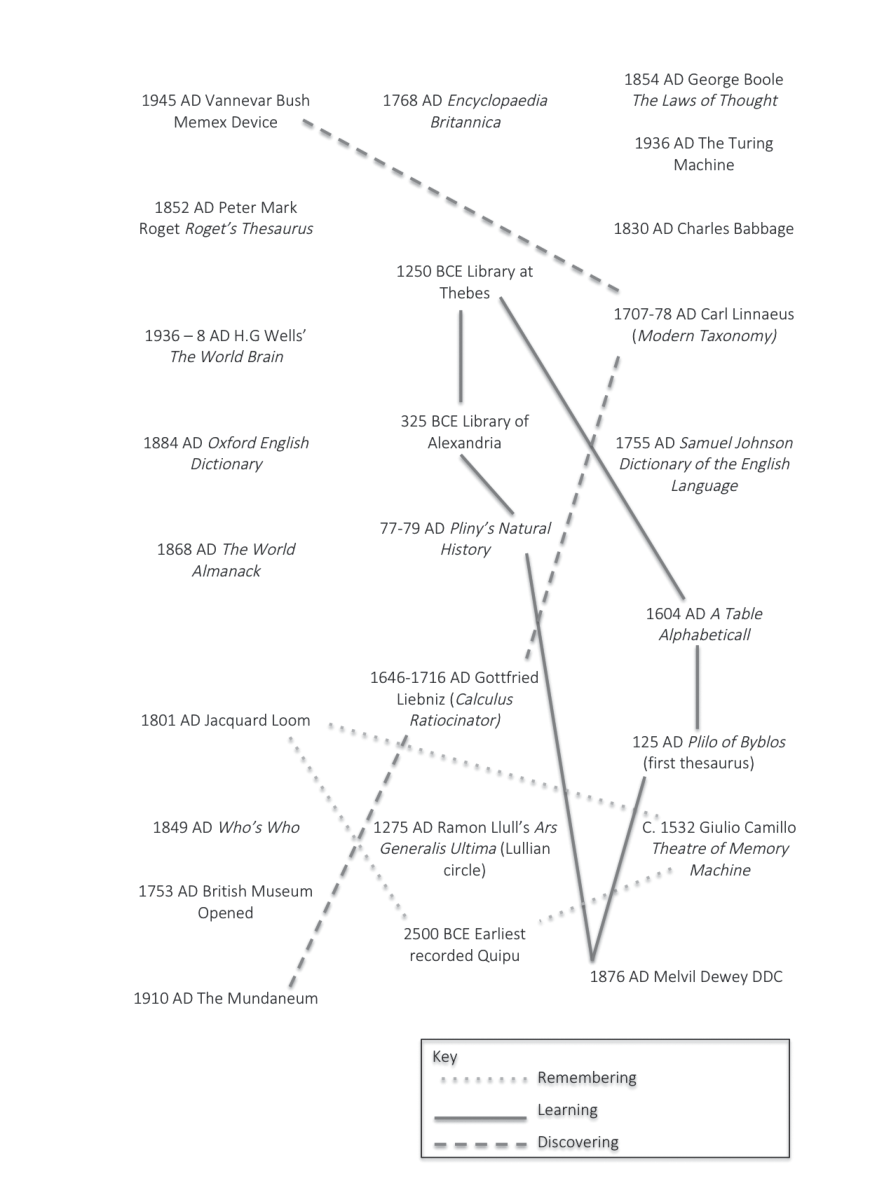
图中文字中文对照(中文版编排)
1945 AD Vannevar Bush Memex Device:公元1945年 Vannevar Bush:Memex装置
1768 AD Encyclopaedia Britannica:公元1768年《大英百科全书》
1854 AD George Boole The Laws of Thought:公元1854年 George Boole:《思维规律》
1936 AD The Turing Machine:公元1936年 图灵机
1852 AD Peter Mark Roget Roget’s Thesaurus:公元1852年 Peter Mark Roget:《罗杰同义词词典》
1830 AD Charles Babbage:公元1830年 Charles Babbage
1250 BCE Library at Thebes:公元前1250年 底比斯图书馆
1707–78 AD Carl Linnaeus (Modern Taxonomy):公元1707–78年 Carl Linnaeus(现代分类学)
1936–8 AD H.G Wells’ The World Brain:公元1936–8年 H. G. Wells:《世界大脑》
325 BCE Library of Alexandria:公元前325年 亚历山大图书馆
1884 AD Oxford English Dictionary:公元1884年《牛津英语词典》
1755 AD Samuel Johnson Dictionary of the English Language:公元1755年 Samuel Johnson:《英语词典》
77–79 AD Pliny’s Natural History:公元77–79年 普林尼:《自然史》
1868 AD The World Almanack:公元1868年《世界年鉴》
1604 AD A Table Alphabeticall:公元1604年《字母顺序表》
1646–1716 AD Gottfried Leibniz (Calculus Ratiocinator):公元1646–1716年 Gottfried Leibniz(推理演算)
1801 AD Jacquard Loom:公元1801年 雅卡尔提花织机
125 AD Philo of Byblos (first thesaurus):公元125年 比布鲁斯的斐洛(首部词语汇编)
1849 AD Who’s Who:公元1849年《名人录》
1275 AD Ramon Llull’s Ars Generalis Ultima (Lullian circle):公元1275年 Ramon Llull:《终极通用术》(卢尔圆盘)
C. 1532 Giulio Camillo Theatre of Memory Machine:约1532年 Giulio Camillo:记忆剧场装置
1753 AD British Museum Opened:公元1753年 大英博物馆开放
2500 BCE Earliest recorded Quipu:公元前2500年 最早有记录的结绳
1876 AD Melvil Dewey DDC:公元1876年 Melvil Dewey:杜威十进分类法
1910 AD The Mundaneum:公元1910年 世界知识馆
Key:图例
Remembering:记忆
Learning:学习
Discovering:发现
图1展示了一些与搜索引擎有关的思想、制度和技术。我可以添加更多参照点,就像星图会依据更好的望远镜和更深入的研究增添星星一样。这种呈现信息的方式把信息从原有语境中抽离出来,进而使我们聚焦于当代关于搜索引擎是什么的理解。我们可以增加不同类别来归组这些例子,也可以扩展现有类别,或把某些例子完全移除。这种开放的过程,比一条简化工具和思想历史的静态时间线,能带来更有意义的问题。通过建立临时联系而开启的问题,可以进一步展开:在我们的关联星座中选一个点,讨论搜索引擎如何以不同方式与其他媒介发生关系。我将勾勒搜索引擎的三种用途,称之为记忆、学习和发现。这三种用途绝非穷尽,却有一系列历史上的先祖,因而可为我们提供多种彼此重叠的关联星座。与搜索引擎有关的行为有很多,但这三种对于联系到我们的知识观尤其重要。把它们呈现为星座,意味着这些类别是灵活的,还可以添加新的类别。这样,我们就拓宽了围绕搜索引擎的讨论。
记忆,是指使用搜索来回想日期、姓名之类的信息,而我们对这些信息的语境已有清楚把握。学习,是指针对自己部分了解的领域搜索详细信息。发现,则是使用搜索为自己带来出乎意料的东西。我会结合前面那幅临时关联星座中的一些例子,勾勒这三种模式,希望建立一组与其他技术相连的根茎式联系,也希望改变一些关于网络搜索引擎之新颖性和独特性的观念。
记忆(或者更准确地说,遗忘)
知识有两种。我们自己了解某一主题,或者知道在哪里能找到关于它的信息。[1]
我使用“记忆”一词,是指用搜索引擎唤回那些我们原本会说自己知道的事情——例如,“那部电影里的那个人是谁来着?你知道的,就是那个人!”以及“在他们第二张专辑里,不管那张专辑叫什么”。这些话凝结了这种感受。我们经常依赖这类心智占位符,无论它们多么空洞,因为我们知道,正确的搜索会提醒我们某些事实。正如心理学家 Stephen Kosslyn 所说:“一旦我在互联网上查过某样东西,就不需要保留全部细节以备将来使用——我知道在哪里可以再次找到那些信息,而且可以迅速而轻松地做到。更一般地说,互联网的运作就仿佛它是我的记忆。”[2]许多人批评这类行为,认为它是现代技术使我们的知识与理解变得不那么 扎实的一种方式。Nicholas Carr 在2008年发表于《大西洋月刊》的文章《Google 正在使我们变笨吗?》中,使用了一个很适合代表常见观点的比喻:互联网已从根本上改变了我们的思维方式。
网络似乎正在一点一点削弱我集中注意力和沉思的能力。我的头脑如今期待以网络分发信息的方式接收信息:一股快速流动的粒子流。我曾是词语海洋中的水肺潜水者。如今,我像一个骑着水上摩托的人,在水面疾驰。[3]
Carr 的比喻反映了关于互联网的一整套心态:我们深切地感到,搜索引擎、超链接和网络出现之前的时代,与我们彻底未来化的当代处境之间,有一道巨大的距离。仿佛我们已经越过了某个重大的技术分水岭,甚至是最重大的那个。Carr 接着描述互联网这个“力量无法估量的计算系统”,如何“将我们大多数其他智力技术纳入自身。它正在成为我们的地图和时钟、印刷机和打字机、计算器和电话,以及收音机和电视”。[4]
Carr 罗列的例子强化了这样一种技术变迁观:技术是目的论的、整体划一的,而且总是从较不复杂走向更复杂。新技术会把我们带往从未去过的地方,也会取代我们熟悉的技术;这个想法支撑了一种信念,即我们无法回到那个简单、真实的美好旧时代。再回到 Kosslyn 对互联网出现后新行为的描述,它为 Carr 挑衅性的论点提供了较积极的平衡。Kosslyn 强调:“持续连接带来了种种取舍;没有什么是毫无代价的。但在这个例子中,权衡之下,代价很小。与把互联网融入自己的心智和情感处理过程之前相比,我如今是个更好的思考者。”[5]
即使是对互联网的积极辩护,通常也摆脱不了这种电视改造节目式的“改造前与改造后”比喻。这种思维强化了一种态度:媒介与技术仿佛由历史的传送带运到我们面前,对我们发生作用,每一件新到之物都让其余事物黯然失色。在引言中,我提到亲友会绕开涉及互联网究竟是什么的术语,倾向于避免具体或技术性语言,以免显得无知。专业评论者、理论家和思想家的许多论证,也衍生出类似态度;我斗胆猜测,他们大多数人对术语与定义其实完全熟悉。然而,许多这样的思想者出于各种原因,把互联网、万维网、搜索以及新技术的其他方面混为一谈:也许是为读者着想,或是为了让自己的具体主张显得更加根本或普遍。但这样做强化了一个观念:问题或益处都来自连接性的一次整体性变迁。当技术评论者谈论互联网,以及它相较传统媒介更便于搜索和查找、相互联系更紧密、速度更快时,他们很多时候主要是在谈搜索引擎的影响。如果我们能更具体地指出 究竟是哪些技术可能正在改变我们的行为,我们就更有机会找到可与其他现存技术比较的方面,而不会把互联网时代说得像一次进入全然未知之地的旅行。
今天,把 Google 说成心智的义肢固然流行,但延伸心智和记忆的技术并不新鲜。有很多技术与媒介会改变我们的思考和记忆方式;有些为人熟知,而且往往仍在使用,有些则鲜为人知。我借用 Marshall McLuhan 的广义“媒介”概念,即“媒介是一方的技术与另一方的身体之间的交汇点或界面”。[6]Samuel Johnson 在上面的题辞中提到知道去哪里找的知识时,首先想到的是图书馆。事实上,那段引文的后半句说:“当我们探究任何主题时,首先必须知道有哪些书谈到过它。”[7]这类结构化资源将在下文“学习”一节中讨论;这里我要讨论的行为,比熟悉图书馆所需的知识更基本。换言之,这条谱系围绕的是记忆工具。
为了进一步说明记忆问题,我现在介绍一种非常古老、具有鲜明文化特性的技术:结绳(Quipu)。
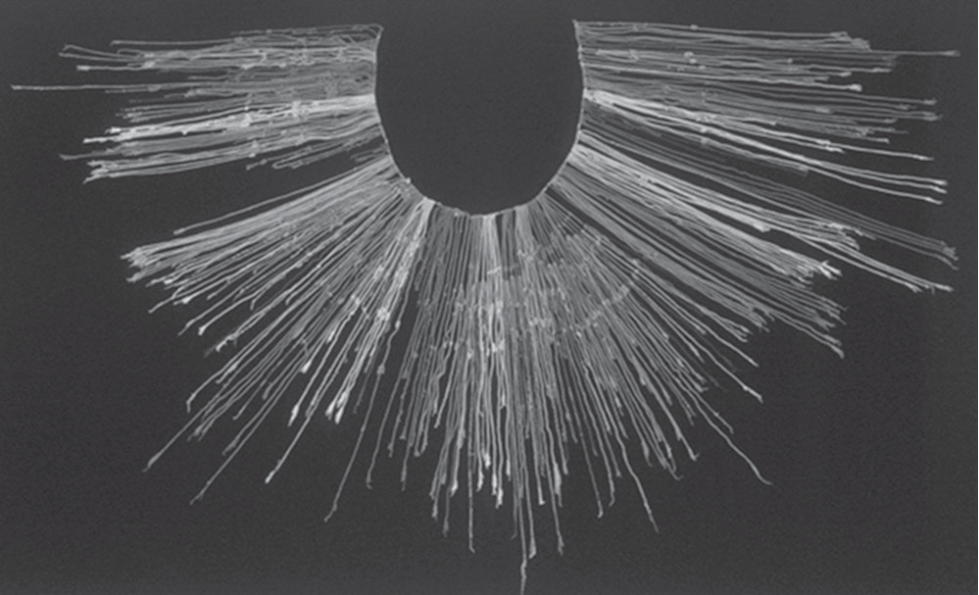
在古代南美洲的安第斯地区,一种叫作结绳的特殊技术被用于若干不同区域。这种装置常被称为“会说话的绳结”,它
由一根粗绳组成,下面像流苏一样悬挂着若干细绳。这些细绳按照各自所代表对象的性质,使用不同的颜色:例如,黄色代表黄金,红色代表军队,白色代表和平。颜色数量有限,因此会按照结绳总体的目的和范围,具有不同的意义。[8]
结绳可以作为复杂叙事的记忆装置,可以记录仓储、规则和决策,也可以提供某一区域的地图,此外还有许多历史学家至今未能完全理解的可能用途。摆弄细绳形成一组组信息,解开时就发挥助记作用。这类似于在手帕上打一个结,提醒使用者某件事,但其复杂程度无法相提并论。结绳依赖使用者已有的记忆和对语境的理解;这种指定的使用者叫作 Quipucamayu,即“结绳保管者”。[9]同一组细绳可用于多种不同需要,所以使用者不仅必须知道语境,还必须知道最初打结时可能编码进去的原始意图、倾向和其他内嵌行为。因此,结绳并不只是外部记忆储存库或记忆装置;它被用作一种“唤起记忆”的装置。其中编码的是恰到好处的遗忘程度。不过,这种遗忘程度并非以浅层和深层来组织,因为它并没有提供一种结构,让更详细的记忆各就其位。相反,结绳为一种更加整体性的过程提供基础,在这一过程中,记忆嵌入行动。结绳在许多世代和多个地区被持续、反复使用,既容许变化和适应,也固化了不同知识与行为类型之间的联系。结绳是动态的:它改变使用者的思考和记忆方式,也改变个人与社会建构自身身份的方式。
我并不打算把结绳与 Google 直接比较。直接比较会抹平每种技术特有的媒介性质。它们在历史与语境上的差别巨大,所以玩一个“找不同”的游戏显然没有帮助。但是,如果我们利用这种语境之间的巨大鸿沟,将它推至极限,接受其中的所有纷乱,就能依照各项技术自身的条件,更深入地理解它们。如果我们试图用家谱或线性的技术演化,把结绳的使用与搜索引擎的使用连接起来,我们一定会失败;甚至不能把它们说成关系最疏远的表亲。然而,把二者并置,可以拓宽思考,使我们不再过分局限于仅在自身语境内考察搜索引擎。
结绳是一种古老技术。许多考古学家,尤其是 Ruth Shady,认为已发现的最早实例约有4500年历史。[10]人类学家 Gary Urton 通过文字档案证据表明,
西班牙征服时期(始于1532年)写成的文献中,包含对 khipus 的描述;这些描述表明,印加人用 khipus 记录数量数据(例如人口普查和贡赋记录),也记录歌曲、家谱以及其他含有历史信息的叙事形式。[11]
考虑到在这两个时代之间发现的结绳数量,我们可以说,结绳并非昙花一现的现象。它们嵌入一种文化,并在数千年间从根本上改变了该文化中知识与记忆的性质。然而,其确切应用方式并不明确,因为它们用于没有文字的社会,也就是说,没有书面叙述。没有关于其使用的文字记录,我们对结绳的历史知识几乎变得神秘,真正嵌在它自身的媒介之中。基于这些原因,许多学者和研究者质疑对结绳的通常描述。Urton 是批评传统结绳用途说明的主要人物之一。Urton 反对这样一种“观念:结绳代表一种独特的、私人的——即以个人记忆为基础的——记号系统,因此,任何一件特定结绳,只有制作它的人才能准确解释”。[12]Urton 援引历史证据,指出印加帝国具有高度官僚化的体制,许多结绳用于传达法律和国家事务。结绳的使用,与其说像个人的记忆技巧,不如说像一系列方言和非正式借用的临时对话。
结绳使用了这么长时间,演化出某些共同惯例并不令人意外。然而,有趣的是这些共同编码或重复实践的可塑性质。Quipucamayu——结绳使用者——的工作既是非常私人的,也与他人共享;由于绳线和绳结的组合具有开放的可能性,其意义仍然暧昧。这种灵活性始终允许每条结绳信息向不同用户传递、或帮助他们回忆起或多或少的信息。这种歧义,使我们从21世纪视角确定这种装置精确用途的困难加倍。学者无法全面理解结绳,不仅是因为缺乏经转译的规则、礼仪和应用方法;还完全有可能,结绳保管者拥有如此多样的方式,让结绳的个人用途与交流用途彼此交叉,以至于我们可以设想,在他们所处的时代,也并没有对结绳的普遍共同理解。利用结绳记忆与遗忘的性质,必然妨碍人们完整理解这项技术如何运作。结绳以多种不同而流动的方式被使用,正是这种行为的可塑性,改变了使用者的思维与知识之间的关系。
由此,我们回到搜索引擎,以及当代讨论它们的方式。虽然无法得知古老结绳技术的精确使用细节,但我们知道,仅仅讨论它可能如何被运用,就能让我们追问记忆与思考之间的相互作用。结绳能否仅仅存在于个人层面?它们是否必须连接到一个 考虑更广泛话语的跨媒介场域?当个人记忆通过共享媒介得到组织时,是否必然转变为半共享的编码?提出这些问题,让我以新的眼光看待自己把搜索引擎作为记忆工具的使用。前面提及人们利用搜索引擎记起演员姓名或专辑标题的不同方式时,我描绘的是搜索如何改变个人的记忆与遗忘。我们可能从经验中发展出个人编码。对于经常忘记的姓名,我常常搜索同一个查询,而且已经知道哪些搜索总会返回我要找的姓名,哪些不会。记住应当使用哪些搜索词,成为一种非常个人化的编码。因为以前曾尝试回忆某些信息,我与这些信息便有了更直接的联系。然而,搜索不可避免地是社会性的。我的搜索模式属于我自己,但这只是因为陌生人那些未曾言明的搜索行为。个人试图把搜索引擎用作记忆装置时,常常会遇到违背直觉的一点:我们必须在他人个人助记模式的集合中周旋。在最初的相关技术星座图中(见图1),我把结绳归入“记忆”这一标题下。然而,这个例子表明,结绳和其他记忆媒介无法脱离的协作语境,使“技术可以仅仅被用来记忆”这一理想化观念变得复杂。仅这第一个例子,就已经使我们能够在多大程度上为记忆、学习和发现划出恰当边界成为问题。
媒介考古学家 Jussi Parikka 转述德国媒介理论家 Friedich Kittler 的话,以如下论点描述这种情况:
媒介决定我们的处境,早已进入我们的头脑,进入我们理解和写作的能力、理论概念、记忆等事物之中;不过,这些媒介考古式的视角,阐明的是更宽广的跨媒介场域,在那里,人体作为现代化过程的一部分受到训练。[13]
结绳与搜索引擎之间的联系既不直接,也绝非具体确定;然而,按照 Parikka 的评论,两种技术仅凭自身构成的性质,就以可比较的方式塑造使用者。Parikka 所说的跨媒介场域,关乎同一技术的使用者之间发展出的无意识模式;在孤立与社会两种语境中,这些模式组织他们的个人使用方式,以及某些能力的发展。通过结绳,我们可以看到,“记忆”这个星座如何瓦解自身。
学习(或者说,搜索细节)
在历史的任何时刻,制度都会试图通过控制文本相互排列的方式,使当前版本的知识与真理获得合法性。[14]
我们可能把搜索引擎与其他技术联系起来的第二种方式,是通过构成学习的行为。这里指的是需要先备知识的技术,而使用这些技术又能增进或深化这些知识。在很多方面,这一描述对应于上文对记忆技术的划分。搜索引擎与其他技术之间常见的一种比较,是日益数字化的时代里纸质书的未来。这种比较同样把互联网出现之前传统的知识传递和思想表达方式,塑造成一种整体划一的形象。围绕纸质书地位的许多讨论,来自关于学术的重要性、传统边界,以及专家与业余者之间等级关系等更广泛的议题。然而,许多人如此笼统地谈论书的未来时,他们所指的可追溯到历史学家 Peter Burke 所说的“由课程、图书馆和百科全书组成的智识三脚架”。[15]Burke 描述了在15世纪,知识的组织和教学采用统一方式——通过三艺与四艺的线性、顺序性体系——所以这三个组成部分相互强化。“书籍的秩序会复现大学课程的秩序”,[16]而正是这种秩序,而不是我们现代的字母排列,组织了百科全书。这种安排在不同知识类型之间强加严格关系。学生必须先在语法、逻辑和修辞方面打好基础,才能进而学习算术、几何、天文学和音乐。每个领域都强化占主导地位的知识组织方式,使系统内置的许多关联与等级变得自然。这一体系也很难受到质疑,因为如果没有主导性大学课程提供的充分语境,某些思想领域便很难被发现。
我们可以说,尽管自15世纪以来发生了许多变化,不同知识制度仍然在相互强化。要进入某些领域,就必须先学习若干基础学科;图书馆按照主导的学习范式收藏图书;百科全书包含图书馆的浓缩版本——这些想法依然存在。我们可以指出,如今大多按字母排列的百科全书,提供了多个进入点,使学习和理解更加灵活,也更具个人色彩。大学让学生拥有更多自由和专业化选择,不再试图在学生头脑中映现图书馆与百科全书的全部内容和结构。图书馆如今采用多种不同的排列方式,这些差异说明,没有哪一种书籍秩序是理想或客观的。下面,我会简短关注图书馆及其排列方法。与搜索引擎类似,一项实用技术的发展,也引发了态度上十分哲学性的变化。
图书馆的许多传统是在时间中逐渐改变的。不过,一次突变来自 Melvil Dewey 在1876年创立杜威十进分类法(Dewey Decimal Classification,DDC)时的创新。这套系统为图书馆提供了一种更流动的方式,让 书籍彼此互动,同时又强化了旧有的等级与划分。在关联图(图1)上标示星座关系时,把使用搜索引擎的过程与心态,同19世纪后期用户与图书馆内书籍关系的变化并置,或许有益。在 DDC 之前,图书馆目录通常按“字母分类式”编排,用来标示书的主题与位置。[17]图书一般归在一个宽泛类别下,不再细分。索书号的其余部分则指向图书馆内的某个具体位置。例如,《物种起源》可能被标为 J429:J 表示生物学,4 表示壁龛中的第四层,2 表示第二块搁板,9 表示第九本书。当实体图书馆搬迁,或藏书增长超过空间极限时,馆藏往往需要重新编号。[18]书架上的图书经常依获得日期排列,因为如果试图按字母顺序或主题细分类排列,每购入一本书,就需要对相当一部分藏书重新分类。
19世纪的图书馆比今天小得多,用户也少得多,而且这些用户通常以教师或学生身份隶属于某个学术机构。典型的图书馆用户会通过大学课程大纲、百科全书或学术著作发现一本书,从而强化 Burke 所说的“智识三脚架”。[19]随后,他们依靠自己或图书管理员的知识确定主要主题,再查阅书面索引——关于该书位置的唯一信息来源。这套系统存在几个问题。首先,图书馆不像今天这样允许广泛浏览;主要类别过于宽泛,无法支持半偶然性的研究行为。编目和检索都需要学科知识,这就迫使获取新知识的过程遵循传统模式,限制新的思考方式。其次,书面索引使用与维护都很费时间;如果一本书在编目时出了错,它实际上就会彻底丢失。此外,目录是手写的,不仅容易出错,而且意味着每个图书馆通常只有一两套目录。由于目录十分珍贵,使用时需要图书管理员密切监督与指导,导致研究较不独立。最后,DDC 之前的系统具有特殊性,关注在某一个图书馆空间内到哪里找书,这使图书馆之间不易比较,妨碍了对多个图书馆的利用。
所有这些问题,都源自 DDC 与它试图克服的图书馆系统之间的一项主要差异:在 DDC 之前,图书馆分类号关联的是实体图书馆空间,而 DDC 分类号指向书籍。这是一个重要区别。DDC 标志着书籍与图书馆之间等级关系的逆转。它把重心从“由若干有序书籍构成的实体图书馆空间”,移向“共同构成图书馆的若干有序书籍”。书籍根据彼此关系分类;虽然 Dewey 的类别依据现有结构,这一变化仍带来新的灵活性,为如何接近思想并将其联系起来,开启新的可能。
图书馆分类中的这一变化,是学习技术的一次转变:导航信息的方式发生改变,影响既有语境,并进而帮助产生新语境。
一个事实仍然存在:某一图书馆内的书,需要以特定的相互关系存放,而用户必须理解这些关系,才能进入其话语。把搜索引擎用于学习,即增加用户对某个已熟悉知识点的细节了解,或许不同于把搜索引擎用作自动记忆装置。搜索引擎技术提供进入点;网络中一个未被索引的页面,很像图书馆里被放错书架的书,它以一种几乎完全阻止使用的方式脱离语境。正如网页之间的链接在某些方面比内容更重要,图书馆空间内实体书之间的关系,也提供了一种平行的语境思考方式。虽然19世纪图书馆的变化并不能通过传统的线性进程连接到搜索引擎,但将它们并置,可能有助于我们认识到:以实用目的设计的技术,在整个历史中都改变着传统的知识安排,而不只发生在互联网出现之后的世界。把 Burke 的智识三脚架中延续的制度性使用结构与搜索技术联系起来,可以提醒我们,搜索与检索并不是新事物;信息爆炸也不是,学者们常常宣称它出现了,而且几百年来一直如此。组织看似过度充裕的知识这一难题,远早于人们经常与之联系的数字世界。技术必须在学习所需的先备知识与开放式发现之间求得平衡,这一直属于远比我们现代搜索引擎困境更广阔的技术史。
发现(或者说,没有终点或缘由的研究)
如果人被融入一种全知的存在,如上帝自身,就不再需要文献记录。……宇宙中的一切,以及人的一切,都会在产生时从远处被记录。这样,世界的一幅动态图像便会建立起来,成为其记忆的一面真实镜子。……如此一来,每个人坐在扶手椅中,就能够观照造化的整体,或其中某些部分。[20]
到目前为止,我们讨论了构成网络搜索引擎身份的两个领域——记忆与学习——并在一定程度上展示,这些行为中的相似方面也能在其他无直接关系的媒介中找到。我们看到,把搜索引擎放入新的语境,就能更好地提出“它的重要之处何在”这样的问题。正如前文所见,前两个类别彼此交融。这为检验新类别提供了空间,也使连接搜索引擎与其他现象的地图能够重新组织,为可进一步质疑的新视角腾出位置。我将在这一语境中,讨论图1称为“发现”的那一区分。网络搜索引擎有一个主要方面,常常被视为新颖而与旧媒介无关:它能够 让用户接触此前几乎没有经验的、意想不到的知识领域。当然,这种开放行为与前面的区分相联系,因为进行新发现所需的先备知识问题再一次浮现。因此,我们可以提出问题:搜索引擎究竟能在多大程度上,使人以有意义的方式在未探索的信息中自由移动?在此,虽然以往的技术已经在某种程度上得到实施,但比较特定技术的意图,或许更有成效。正如 Eric Kluitenberg 所言:
在多数情况下,这类想象中所包含的期待,远远超出实际媒介机器真正能够做到的事情。然而,实际的媒介机器本身,又被设计者以及公众对它们的理解所赋予或投射的不可能欲望所折磨。从意义而言,想象的媒介机器与实际的媒介机器之间的转换,几乎可以无缝进行。[21]
讨论搜索引擎技术时,想象与现实之间的转换经常发生。思考最初意图与未来可能性时尤其如此,而事情出错时也常常如此。为讨论这种现实与想象技术之间的传递,我现在简要介绍 Paul Otlet 的世界知识馆(Mundaneum),一个试图收集全部人类知识并使之可供获取的机构。世界知识馆实际上建成过,而以不可能为目标,是其身份不可分割的一部分。
Paul Otlet(1868–1944)是比利时的一位博学家,他一生中很大一部分时间,都与 Henri La Fontaine 合作开展各种事业,希望借此促进世界和平。在他的一生中,世界日渐分裂、敌对;他为连接这个世界提出了许多想法,其中一个就是世界知识馆。世界知识馆计划容纳世界上一切知识;它确实建成,并一度以未完成的状态运作——这也正是现实与想象之间暧昧性的由来。Otlet 在1914年这样描述它:
这些收藏被设想为一个普遍文献总体的组成部分,是对人类知识的百科全书式总览,也是一个由书籍、文献、目录和科学物品组成的庞大智力仓库。它们按照标准化方法建立,通过合作汇集参与协会所能搜集或分类的一切材料而形成。[22]
世界知识馆不只是信息仓库;馆中还有若干工作人员,受雇回答任何愿意支付少量费用的人提出的问题。相较以往传统模式所容许的范围,知识将向更多人开放。这些发明出现的时代并非巧合。Otlet 希望普遍知识能够打破民族主义和阶级 壁垒,让任何人都有机会参与他的项目,在追求知识中成为和平的世界公民。他把世界知识馆视为自己与 La Fontaine 共同设计的世界城市的核心。其他构想也试图以动态而未来化的方式汇集信息,例如 H. G. Wells 的“世界大脑”或 Vannevar Bush 的 Memex;与它们不同,Otlet 在项目的想象终点与组织工作的早期阶段之间进行协调,是其项目的关键。世界知识馆必须建成,才谈得上意义。Otlet 对普遍知识收藏的设计,不仅仅意味着熟悉一个现有系统,或把一种新结构强加于现有材料。世界知识馆的目标,是打破国家与制度壁垒,也打破作者身份、传统和出版物物理限制的壁垒。Otlet“想穿透书籍本身的边界,发掘其中的实质与结论”。[23]
与搜索引擎类似,世界知识馆的工作人员会用从原作品中抽出的引文、照片和影片片段回答查询,同时提供足够参考资料,把它们置于语境中。世界知识馆通过分析书籍和其他材料、选出最重要的结论,再把信息转写到索引卡片上来建构;这些信息可作为事实用于任意多种不同语境。鼎盛时期,世界知识馆包含超过“1200万张独立索引卡片和文献”,[24]并雇有全职操作人员,他们能以逐项个人查询为基础,为任何人回答问题、提供信息并开展工作。1940年纳粹入侵比利时时,世界知识馆被拆空,取而代之的是第三帝国艺术展览。它的遗产仍然延续;20世纪90年代末,人们找到了许多遗存,并在蒙斯市将其重建为一座现代博物馆。
世界知识馆的目标,为我们理解现代搜索引擎技术提供了新的视角。在很多方面,这两个项目彼此相连。Google 的使命宣言“组织全世界的信息”,用于描述 Otlet 的项目,与用于描述 Google 自己同样贴切。[25]把二者并置的益处,简单说,就是提出搜索引擎并不依赖互联网,在当代互联时代之前,人们就曾尝试建造它们。我觉得世界知识馆耐人寻味的地方在于:尽管索引卡片和装着笔记的实体盒子显得老派,尽管目标似乎不可行,即便在今天,它听起来依然具有鼓舞人心的未来感。负责挑出文件中最重要部分的工作团队,以及提出请求时的人际接触与控制,乍看似乎比我们当下秘密算法和黑箱方法的处境更为成熟。或者,全世界的信息脱离个人之手,也会让我们高兴?用机器的计算错误换取人类偏见或错误的减少,是否值得庆祝?如果暂且不考虑项目的可操作性,把世界知识馆当作我们可以追求的一种机构,它是否会显露出,我们对当下搜索引擎处境所抱有的某些希望与忧虑?
希望结绳、杜威十进分类法以及 Paul Otlet 的世界知识馆这些例子,无论其语境多么疏远,都能够在我们思考如何使用与依赖搜索引擎时,打开新的问题与讨论领域。借助将星座映射到历史上互不相关媒介上的比喻,我希望提供更宽广的分析范围,以及更多质疑当下技术的方法。随着例子的展开,文章开头设定的那些星座类别——记忆、学习和发现——已不再泾渭分明。我认为,这表明在我们试图理解一项技术的影响时,围绕它建立多种非线性叙事的过程,或许比传统谱系更富成效。我们不应让分析受缚于不切实际、过分直接的历史时间线,而需要将技术抽离原有语境,以新的眼光看待那些熟悉的技术。如果搜索引擎本身都不尊重传统边界,那么我们研究它们时,又何必尊重这些边界?
参考文献
Baudin, Louis. A Socialist Empire: The Incas of Peru, New Jersey: D. Van Nostrand Company, 1961.
Boswell, James. The Life of Samuel Johnson Volume II, New York: Penguin, 1986 (1791).
Burke, Peter. A Social History of Knowledge: From Gutenberg to Diderot, Malden, Mass.: Polity Press, 2000.
Carr, Nicholas. ‘Is Google Making Us Stupid?’ The Atlantic, July/August 2008, http://www.theatlantic.com/magazine/archive/2008/07/is-google-making-us-stupid/306868/.
Comaromi, John. ‘Knowledge Organized is Knowledge Kept: The Dewey Decimal Classification, 1873–1976’, The Quarterly Journal of the Library of Congress 33 (1976): 17–31.
Google Mission Statement. www.google.com/about/.
Kittler, Friedrich. Optical Media, Malden, Mass.: Polity, 2010.
Kluitenberg, Eric. ‘On the Archeology of Imaginary Media’, in Erkki Huhtamo and Jussi Parikka (eds), Media Archeology. Approaches, Applications, Implications, Berkley: University of California Press, 2011.
Kosslyn, Stephen M. ‘Social Prosthetic Systems’, in John Brockman (ed.), Is the Internet Changing the Way You Think?, New York: Edge Foundation, 2011.
Mann, Charles C. ‘Unraveling Khipu’s Secrets’, Science 309 (12 August 2005): 1008–9.
McLuhan, Marshall. Understanding Media: The Extensions of Man, New York: McGraw-Hill, 1964.
Otlet, Paul. Monde: Essaie d’Universalisme, Trans. Anthony Judge, Brussels: Editions du Mundaneum, 1935.
Parikka, Jussi. What Is Media Archeology, Cambridge: Polity Press, 2013.
Radford, Gary. ‘Positivism, Foucault, and the Fantasia of the Library: Conceptions of Knowledge and the Modern Library Experience’, The Library Quarterly (1992): 408–424.
Rayward, W. Boyd. ‘Visions of Xanadu: Paul Otlet and Hypertext’, JASIS 45 (1994): 235–250.
Urton, Gary. ‘From Knots to Narratives: Reconstructing the Art of Historical Record Keeping in the Andes from Spanish Transcriptions of Inka Khipus’, Ethnohistory 45.3 (Summer, 1998): 409–438.
Wright, Alex. Glut: Mastering Information through the Ages, New York: Cornell University Press, 2007.