将 Google 搜索历史化:搜索结果归档面临的挑战
这个段落位置已不存在。请使用目录或当前章节查找内容。
Jacob Ørmen
将 Google 搜索历史化:搜索结果归档面临的挑战
Jacob Ørmen
谁会不想知道,如果在 9 月 11 日之前不久,把关键词“terrorism”(恐怖主义)输入 Google 搜索栏,会得到什么结果?如果还可以把它与恰好在 2001 年 9 月 11 日或两周之后进行的搜索相比较呢?或者,追溯过去十年中,与“USA”这一查询相关联的网站的搜索排名,又会怎样?
诸如此类的问题困扰着富于想象力的研究者(恐怕尤其是历史学家),而令人沮丧的答案往往随之出现:是的,你其实可以……只要当时有人想到了把它存档。历史资料最主要的问题在于,首先必须有人萌生过制作这些资料的想法。幸运的是,这样的资料已经以多种形式产生并向我们开放,从报纸文章、电影和录像,到官方文件及私人通信,不一而足。近年来,我们还能够用 Twitter 等社交网站的数字数据来补充这些资料类型,由此扩大可以进行回溯分析的传播活动的种类和深度。如今,我认为,我们也需要关注那些不像报纸文章或推文那样容易保存的传播领域:它们对于未来理解 9 月 11 日这样的事件,或者围绕“USA”等特定话题的话语如何展开,同样是相关的资料。Google 搜索就是其中一个领域。
Google 搜索之所以是一个特别有趣的案例,是因为它在搜索引擎市场上占据压倒性优势。对于西方世界许多地区的大多数人来说,Google 搜索是进入网络的核心入口——在美国,这一比例约为 65%,在欧洲大概超过 95%。[1] 它是人们查找各种话题、事件、灾难等信息的重要门户;正因如此,研究以经过排序的搜索结果形式呈现给个人的信息类型,很有意义。记录搜索的发展,对于文化的一般性保存也很重要。正如 Sanz 和 Stancik 所说,Google 搜索向我们提供了“一扇研究文化的独特经验窗口”。[2] 此外,如果我们希望将 Google 这样的搜索引擎理解为互联网上一种特殊的“元体裁”,[3] 就有必要关注这些搜索引擎如何以排序后的搜索结果来安排、或者说中介网络信息。
然而,搜索结果并不容易归档,因为对每一次查询而言,网站的确切排名都会由专有且无法访问的算法(包括 Google 的 PageRank)重新评估,因此不断变化。它们与报纸文章、推文或 Facebook 帖子并不是同一种意义上的文档:后者由某个人发布到网上,对任何访问者而言,呈现方式都或多或少相似。如果没有妥善保存相关信息,就不可能判断某个具体网站在任一时刻表现如何,或者哪些网站当时与某个关键词相关联。由于资料的质量高度依赖于其具体归档方式,这些问题对数字人文学及相关领域的学者十分重要。在这里,我无法明确回答搜索结果归档所面临的挑战(因为我并不认为这里存在明确答案),但会提出其中若干最切要的挑战,并建议一些前进方向。希望这一分析能够为未来研究如何把搜索结果用作历史资料,提供一些新的启发。
“所有那些时刻都会消逝于时间,像泪水消失在雨中”
信息无法找回的问题绝非新事——事实上,绝大多数传播活动始终(而且现在仍然)永远消失了。只要想想所有未被录下的口头交流就知道了。正如仿生人 Roy Batty 在《银翼杀手》中那句富有诗意的话,仿佛“所有那些时刻都会消逝于时间,像泪水消失在雨中”。这也意味着,我们当然无法保存一切(甚至连网上所有材料都不可能保存),因此必须仔细选择希望归档的信息类型及其保存方式。我相信搜索结果能够成为未来重要的一手资料,因此,我们应当关心哪些搜索结果值得归档,以及如何归档。在着手之前,需要理解这类归档工作错综复杂的具体问题。
搜索引擎结果是在线文档的一种特殊类型。搜索引擎提供可检索网络文档的索引,因此一方面,它们是通向丰富信息的一般性入口(有些像传统的图书馆索引)。但是,搜索引擎又会通过各种算法,为进行搜索的人调整具体结果(这更像一位真实的图书馆员)。从这个意义上说,具体搜索结果是搜索者(通过关键词选择、以往搜索历史及许多其他因素)与 Google(通过提供可供搜索的索引)共同创造的。借用 Jensen 等人关于不同 数据类型的讨论,[4] 可以说,结果既是通过索引“找到”的,又是在互动中“制造”的。在那一次特定的搜索行为发生之前,它们根本不存在。因此,随着索引和算法变化,搜索结果不仅可能在不同时间、不同空间呈现不同面貌,还可能因发起查询的个人(“搜索者”)不同而有所差别。结果不像线下文档、在线文章或推文那样,单纯存在于“那里”等人找到、抓取和分析,而必须在搜索行为中被创造出来。这种本体论上的特殊性,为研究搜索结果的学者带来一系列独特的方法论挑战。
近年来,如何将 Google 搜索归档这一实际问题变得更加复杂。Google 于 2010 年 11 月停止了用于搜索 Google 搜索全部索引的官方 API,改以搜索选项极其有限的 Custom Search API 取而代之。[5] 手动定制现有 API,似乎可以绕过 Google 设下的限制,但这样做是否符合 Google 的服务条款(ToS),仍不明确。此外,据 Stack Overflow 上的传言,目前的 Custom Search API 也即将停止使用。[6] 最后,同样重要的是,搜索 API(无论现有还是已停用的版本)所生成的搜索结果,似乎与手动搜索的结果差别相当大。另一种选择是构建网络抓取器,并通过它查询 Google。然而,Google 之前已在服务条款中明确禁止这种做法,而且人们普遍把它视作一种“肮脏的研究方法”。[7] 使用 API 或服务器端访问有明显优势,但服务的访问权限或功能始终存在突然改变的风险,从而严重损害研究项目。因此,这总是一种有风险的解决方案,对于持续较长时期的研究更是如此。这显然不是 Google 搜索研究独有的现象,而是在从在线服务获取数据时通常都会遇到的问题(例如,Twitter 研究者就十分了解 Twitter API 给研究项目设下的限制)。
因此,似乎唯一真正可行的选择,是通过在 google.com(以及其附属子域名)上手动提交搜索请求来收集结果。一种不甚优雅、却相当可行的方法,是使用能够按固定时间间隔自动截取搜索结果画面的研究工具。[8] 这种方式的优点,是保留浏览器窗口中的全部视觉信息;对于关注搜索结果构成的研究项目(例如查询列表中每项结果所占的大小、链接、图像、视频和其他 语境数据的位置),它可能很有用。如果目标是统计分析,这一方法的缺点也很明显,因为信息被“压平”在一幅图像中,而不是整齐地排列在结构化数据库里。当然可以手动重新编码,但即便截图样本较小,这也将是一项十分烦琐的工作。因此,截图最适合把视觉元素纳入分析的定性研究。至于为什么搜索引擎研究中定性方法可能比定量方法更可行这一更一般的问题,我将在后文讨论。
第二个需要考虑的重要问题,是归档多少材料才合适。这当然取决于收集材料的目的,并不存在一个总体适用的答案。在这里,我将介绍两种不同的典型归档模型;我认为,它们提供了把搜索结果作为文档来处理的两种不同途径:
- 纵向模型:一种基本做法,是按照事先规划的固定周期,保存特定查询的搜索结果(例如连续数年,每周一次)。其要点在于记录某些长期在人们心中保持显著性的关键词(换句话说,就是在较长时期内经常被查询的词)。这类关键词可以包括“terrorism”(恐怖主义)、“United States”(美国)和“E.U.”(欧盟)。目标是寻找关键词与网站、图片、视频、话语,或任何其他被认为适合作为分析单位的对象之间的关联。首先,这种方法使我们能够研究特定词语的搜索结果如何在不同阶段(时间上)[9] 和不同地点(空间上)呈现——这就是 Marres 和 Weltevrede 所称的议题的活跃性。[10] 这种方式也使我们能够关注特定搜索行为发生的语境,把进行搜索的个人的语境细节考虑在内(见下文)。这样,我们就可以开展 Laura Granka 所称的“微观层面的研究”,[11] 对宏观层面的一般搜索趋势形成补充。不过,通过建立包含不同时刻定期进行的特定查询的档案,研究者可以跨查询、跨时间比较搜索结果的不同构成。这样,就更容易将 Google 搜索历史化。
- 短期密集模型:另一种办法是在较短、却更加密集的若干轮记录中收集更多材料。如果怀疑某个事件可能大幅扰动搜索排名,这便可能是一种合适的方法。目标是聚焦事件进程中发生的细微变化,再结合事件来分析这些变化(例如,将其与发生的各种子事件联系起来,或与新闻媒体报道、社交媒体活动等作对照)。对 9 月 11 日的(假设性)记录,就是 一例。通过在某些有影响力的事件发生之前、期间和之后保存搜索结果(例如事先安排的大型活动,如选举;或突然发生的破坏性事件,如自然灾害),我们能够研究重大事件期间搜索结果的波动。从这个意义上说,搜索结果记录可用于自然实验研究,其中事件被视为外生冲击。此前,Google 搜索的相关研究已经采用过这类实验,不过当时关注的是点击行为与特定关键词的在线广告活动之间的关系。[12] 然而,由于无法接触 Google 的算法,我们不能隔离变量,因此很难确立外生事件与搜索结果排名之间的因果联系。尽管如此,这个模型仍能为观察重大事件期间不断变化的搜索结果构成提供有趣的视角。
当然,可以将两种模型组合为混合形式(例如丹麦网络档案[13]);上面提出的模型,应被看作搜索结果归档的典型路径,而非精确的操作配方。
两种模型共同面临的最大挑战或许是,搜索排名的波动非常难以解释,因为对于我们这些凡人研究者(意思是:并不受雇于 Google 的人),影响搜索排名的因素数量及各因素的个别权重,都是无法破解的。Dirk Lewandowski 将这些因素分成“依赖查询”的因素(考虑搜索词的位置和顺序,并把搜索词与文档中相关关键词的数量和类型联系起来)及“独立于查询”的因素(主要是网站受欢迎程度,它由 PageRank 算法等因素决定)。[14] 我还要补充个性化因素,也就是所有来自个别用户的信号,例如地理位置、此前的搜索历史、在 Google 能够监测的其他网站上的行为,以及是否登录了某些服务(如 Google 账户)。因此,搜索排名的任何变化,都可能来自算法变化、索引更新,以及个人层面和特定国家层面的因素。下面,我将讨论应对这一严峻问题的方法,并提出一条可能的前进路径。为引导讨论,我会介绍一项小型案例研究;它原本旨在为另一篇文章提供经验材料,最终却成了促使我转而撰写本文的原因。
Google 世界里的猫鼠游戏
2012 年 10 月 14 日,北美山地夏令时约 12:08,在地表上空约 38 千米处,Felix Baumgartner 走出将他送上高空的吊舱,纵身跃入平流层,开始了持续四分钟、朝地面下落的自由落体。约 40 秒后,他达到约每小时 1,342 千米的最高速度(相当于每秒下落一座帝国大厦的高度), 突破音速,几分钟后下降到地面并安全着陆。这一活动以主要赞助商命名为“Red Bull Stratos”(红牛平流层计划),数百万人通过网络同步直播(仅 YouTube 就报告高峰时段有超过七百万观众)和探索频道收看;探索频道也由此获得了史上非黄金时段节目的最高收视率。活动期间,Twitter 上大部分热门话题标签都与 Stratos 有关,而在 Facebook 上,Baumgartner 的粉丝页新增了约五十万个“赞”,并收到大量欣喜若狂的粉丝留言。尽管这一活动的全球意义或许值得质疑(愤世嫉俗者可能忍不住把 Neil Armstrong 的名言改成“一个人的一大步,人类的一小步”),Stratos 确实是一场跨平台的巨大媒体事件——虽然未必符合 Dayan 和 Katz 如今已成为经典的这类事件定义。[15] 对本文而言,更重要的是,它提供了一个研究 Google 搜索的明确案例(大致遵循短期密集模型),也提供了一个更适合讨论实时搜索归档问题的案例。后者被证明是一场令人沮丧却又富于启发的猫鼠游戏,而游戏始于选择合适的搜索查询。
找到合适的钥匙
我在红牛平流层活动举行前约一周,决定对它进行记录,因为当时它已经引起主流新闻媒体相当多的关注。因此我推想,为未来研究记录 Stratos 可能很重要。显然,当人们试图通过 Google 搜索记录这样一个事件时,作为查询使用的确切关键词至关重要,因为它们决定了切入主题的具体角度。所以,选择关键词必须审慎周密。
事件发生之前,我无法确切知道哪些查询在研究语境中最有意义,于是在跳伞前几天测试了若干不同的关键词。最终,我决定记录两个不同关键词:“red bull stratos”(跳伞活动的正式名称)和“Felix Baumgartner”(跳伞者的姓名)。我也尝试了“jump”“stratos”“felix”和“baumgartner”等更一般的关键词,但它们过于宽泛,会包含对于记录此事件而言明显无关的搜索结果。因此,我决定保留更精确的关键词;这当然意味着排除了许多搜索(显然,不少查找此次活动信息的人会使用其他搜索词)。面对这一问题,我判断,在这个具体情境中,假阴性(排除相关结果)是比假阳性(包含太多不相关结果)更好的选择。
比较 Google Trends 上两个查询的搜索量,可以非常清楚地看出,“Felix Baumgartner”作为关键词,在搜索者群体中引起了更大的共鸣。[16] 还很明显的是,尽管活动发生在美国内华达州上空,这些搜索词在中欧国家最受欢迎,尤其是在奥地利。[17] 由于 Felix Baumgartner 是奥地利人,奥地利成为最热门的地点并不令人意外;但这些数字表明,考察欧洲不同国家的 Google 域名同样有意义。[18]
因此,处理搜索查询时最好的办法似乎是:或者聚焦某个预计在整个研究期间仍会保持相关性的特定关键词(例如一个十分一般的词),或者记录若干关键词,让它们共同涵盖事件的不同方面。这一挑战,与在 Twitter 上寻找某些事件的讨论时难以确定合适话题标签的问题紧密相连。在同一时间段比较“Red Bull Stratos”和“Felix Baumgartner”的查询结果,会十分明显地发现,这两个关键词捕捉到了事件截然不同的方面。“Red Bull Stratos”更多地把事件与官方来源(包括红牛公司本身)关联起来,而搜索这位太空跳伞者的姓名,则会得到更侧重个人的结果(其中包括他的 Facebook 页面)。正如 Twitter 研究中特定标签决定了可以捕捉到何种讨论一样,关键词也界定着 Google 搜索研究的范围。必须谨慎选择词语。在这方面,预备研究(简单地在不同语境下尝试不同关键词)和 Google Trends 的数据,都大有帮助。
谁是被研究者,谁是研究者?
系统研究 Google 搜索的困难在于,Google 很快就会意识到自己正在被研究。尽管所谓的“霍桑效应”(即作为研究对象的人意识到研究者正在研究自己,并相应调整行为)在后续研究中受到了质疑,[19] 在研究 Google(及类似公司)的语境中,提出这个问题或许仍然有意义:这些服务会在多大程度上针对我们的研究作出调整?在我看来,调整既可能非常间接,体现为搜索结果的呈现方式;也可能非常直接,即搜索引擎干预研究。图 1 展示了后者的一个例子:搜索引擎检测到某个 IP 地址的可疑行为,便暂时阻止这台特定计算机进一步发出请求。
Ethan Zuckerman 描述了 Google 可能进行间接干预的两种重要方式。第一种是:当 Google 收到来自同一 IP 地址的大量查询时,可能刻意将搜索结果稍微随机化,以掩盖算法的运作。Zuckerman 说:“你轮询搜索引擎越快,得到的变异就 越多,也就越难刻画它的行为。”[20] 第二种是实验。Google 不断进行测试(例如 A/B 比较),以判断用户最有可能与哪类搜索结果(及设计元素)互动。由于这些问题,要确定某个对象为何被排在某一特定位置,就变得十分困难。
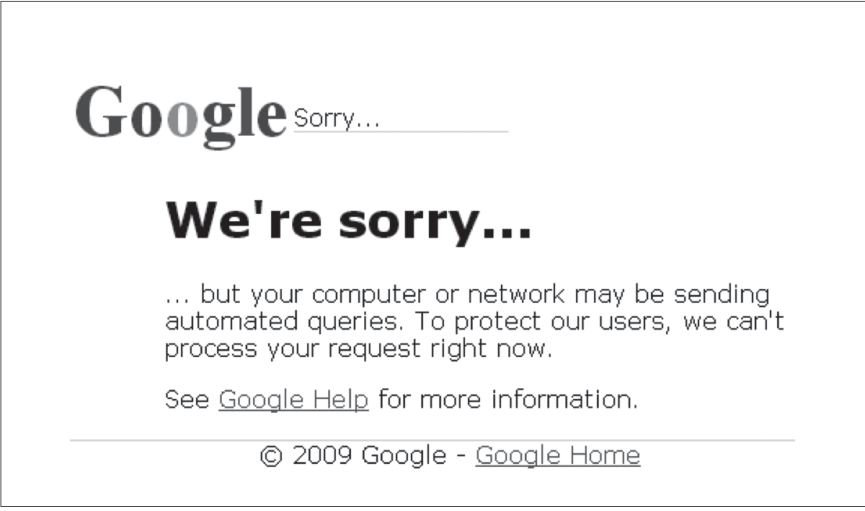
图中文字中文对照(中文版编排)
Google Sorry…:Google 抱歉……
We're sorry…:非常抱歉……
… but your computer or network may be sending automated queries. To protect our users, we can't process your request right now.:……您的计算机或网络可能正在发送自动查询。为保护用户,我们目前无法处理您的请求。
See Google Help for more information.:更多信息请见 Google 帮助。
© 2009 Google - Google Home:© 2009 Google - Google 首页
我们作为研究者需要问自己:当 Google 也在研究我们时,我们如何研究 Google?对于这个问题,我唯一能提供的答案是:我们需要了解搜索时使用的设置,然后接受这样一个事实——归根结底,我们永远无法真正知道其中的因果关系。
我们知道你在哪里……也知道你说什么语言
我们尤其需要高度留意的两个排名因素,是语言设置和 IP 地址。图 2 展示了一个尝试的结果:我在 google.at(Google 搜索的奥地利版本)上查询“Felix Baumgartner”,以期从奥地利视角观察这一活动。尽管这么做是为了特意避开丹麦搜索结果,Google 仍把这些结果放在了显著位置。结果中有一段来自红牛网站丹麦语版(redbull.dk)的视频,还有一条来自丹麦最大电视频道(nyhederne.tv2.dk)的新闻。此外,左侧面板中的语言设置仍然是丹麦语。除此之外,只有一个德语网站(wikipedia.de),这似乎很可疑,尤其考虑到该活动在奥地利获得了极大关注。由于我没有将 IP 地址换成德国服务器的地址,而且默认语言设置为丹麦语,这些因素很可能影响了搜索引擎向我提供这些结果的决定。
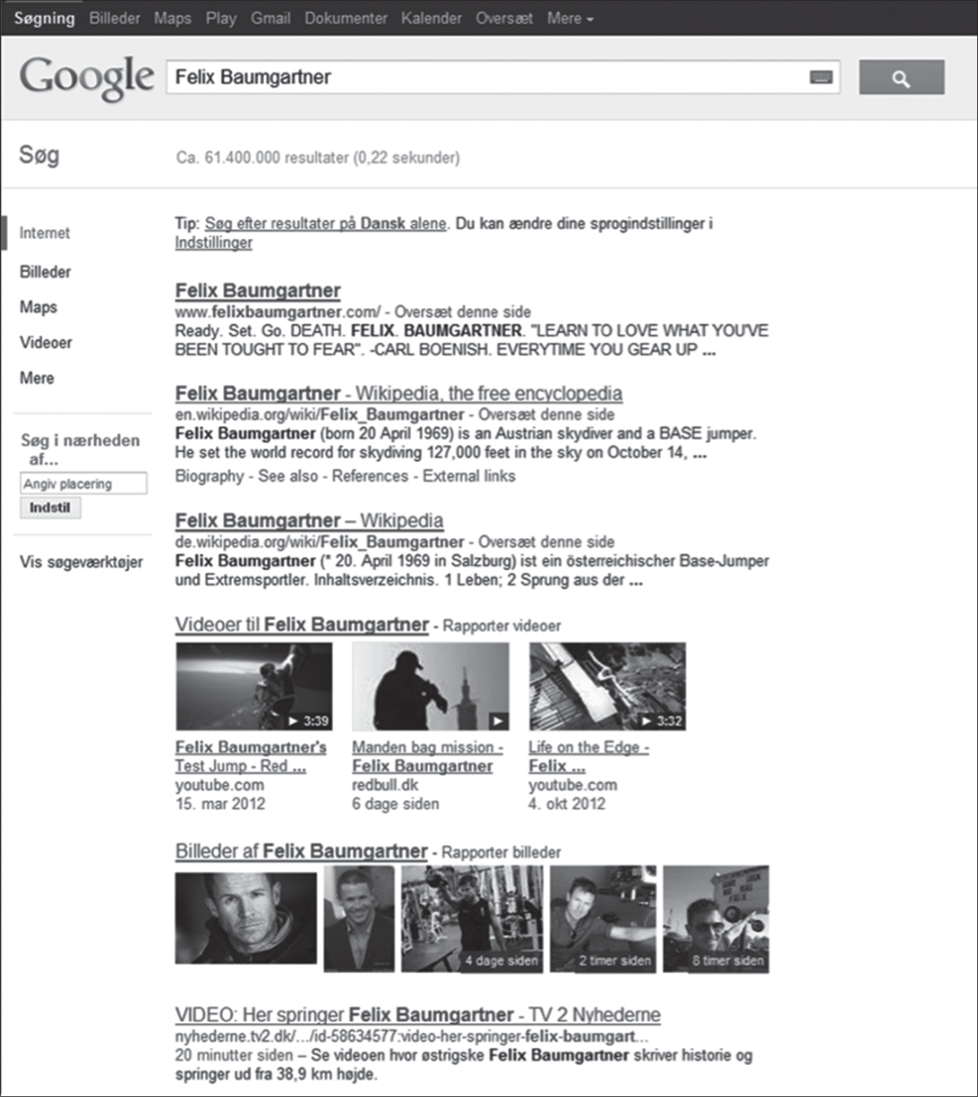
图中文字中文对照(中文版编排)
Søgning:搜索
Billeder:图片
Maps:地图
Play
Gmail
Dokumenter:文档
Kalender:日历
Oversæt:翻译
Mere:更多
Søg:搜索
Felix Baumgartner
Ca. 61.400.000 resultater (0,22 sekunder):约 61.400.000 条结果(0,22 秒)
Internet:互联网
Videoer:视频
Søg i nærheden af…:搜索附近……
Angiv placering:指定位置
Indstil:设置
Vis søgeværktøjer:显示搜索工具
Tip: Søg efter resultater på Dansk alene. Du kan ændre dine sprogindstillinger i Indstillinger:提示:只搜索丹麦语结果。可在“设置”中修改语言设置。
Oversæt denne side:翻译此页
Ready. Set. Go. DEATH. FELIX. BAUMGARTNER. “LEARN TO LOVE WHAT YOU’VE BEEN TOUGHT TO FEAR”. -CARL BOENISH. EVERYTIME YOU GEAR UP …:准备。就位。出发。死亡。FELIX。BAUMGARTNER。“学会爱你被教导要害怕的事物。”——CARL BOENISH。每当你穿戴装备……
Felix Baumgartner - Wikipedia, the free encyclopedia:Felix Baumgartner——维基百科,自由的百科全书
Felix Baumgartner (born 20 April 1969) is an Austrian skydiver and a BASE jumper. He set the world record for skydiving 127,000 feet in the sky on October 14, …:Felix Baumgartner(生于 1969 年 4 月 20 日)是奥地利高空跳伞及定点跳伞运动员。他在 10 月 14 日从空中 127,000 英尺处跳下,创下高空跳伞世界纪录,……
Biography - See also - References - External links:生平-另见-参考文献-外部链接
Felix Baumgartner – Wikipedia:Felix Baumgartner——维基百科
Felix Baumgartner (* 20. April 1969 in Salzburg) ist ein österreichischer Base-Jumper und Extremsportler. Inhaltsverzeichnis. 1 Leben; 2 Sprung aus der …:Felix Baumgartner(1969 年 4 月 20 日生于萨尔茨堡)是奥地利定点跳伞及极限运动员。目录。1 生平;2 从……跳下
Videoer til Felix Baumgartner - Rapportér videoer:关于 Felix Baumgartner 的视频-举报视频
Felix Baumgartner’s Test Jump - Red …:Felix Baumgartner 的测试跳伞-红……
Manden bag mission - Felix Baumgartner:任务背后的人-Felix Baumgartner
Life on the Edge - Felix …:边缘生活-Felix……
- mar 2012:2012 年 3 月 15 日
6 dage siden:6 天前
- okt 2012:2012 年 10 月 4 日
Billeder af Felix Baumgartner - Rapportér billeder:Felix Baumgartner 的图片-举报图片
4 dage siden / 2 timer siden / 8 timer siden:4 天前/2 小时前/8 小时前
VIDEO: Her springer Felix Baumgartner - TV 2 Nyhederne:视频:Felix Baumgartner 从这里跳下-TV 2 新闻
20 minutter siden – Se videoen hvor østrigske Felix Baumgartner skriver historie og springer ud fra 38,9 km højde.:20 分钟前——观看视频:奥地利人 Felix Baumgartner 创造历史,从 38,9 千米高处跳下。
〔原图局部文字存在分辨率、裁切或遮挡限制;译文保留可辨识范围,不补写未出现内容。〕
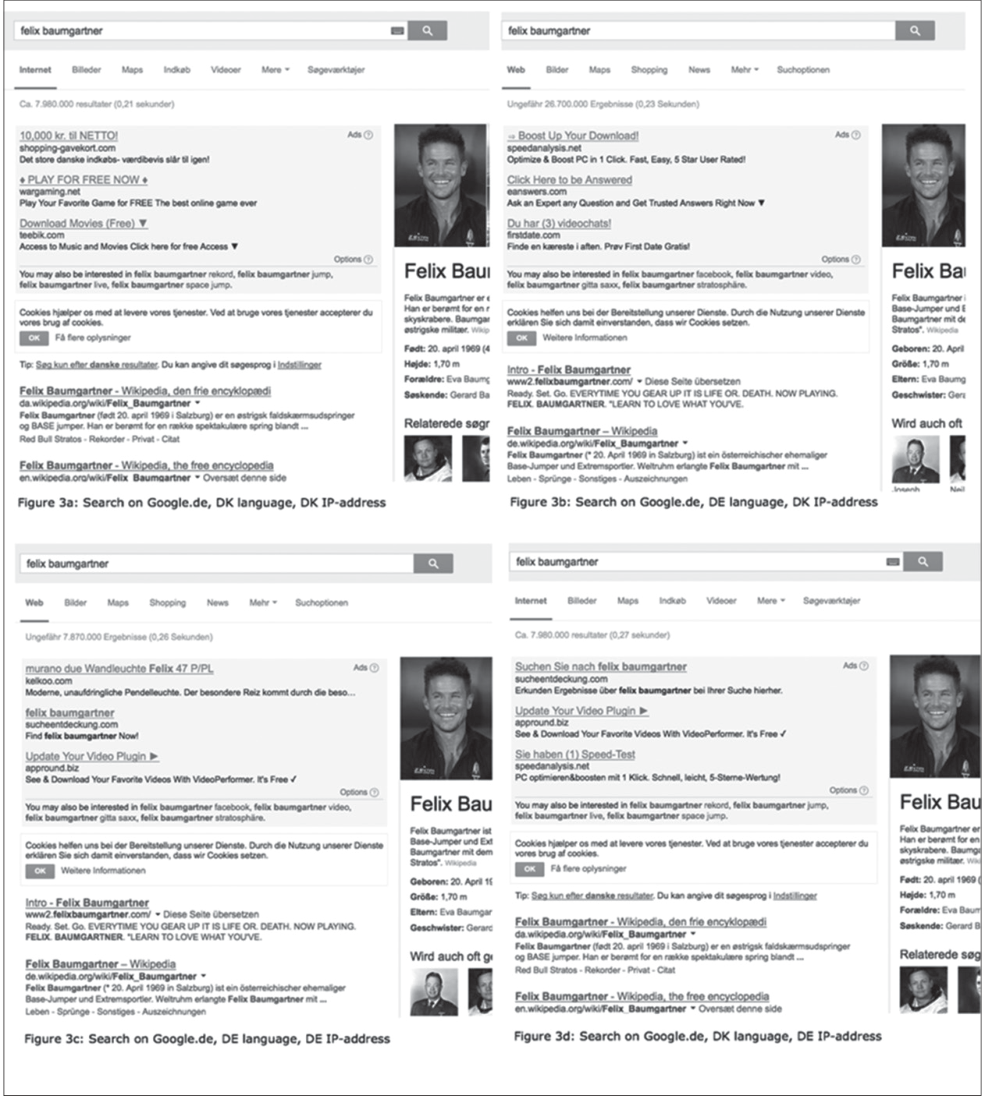
为了更清楚地了解语言设置或 IP 地址是否会影响搜索结果的构成,我进行了一个小实验(见图 3)。我在 Google.de(德国域名)上,以四种不同设置查询“Felix Baumgartner”:一种将语言设为丹麦语,使用我在丹麦哥本哈根的常用 IP 地址(图 3a);一种将语言设为德语,使用我在丹麦家中的 IP 地址(图 3b);一种将语言设为德语,使用德国 IP 地址(图 3c);还有一种将语言设为丹麦语,使用德国 IP 地址(图 3d)。自然搜索结果的最大变化,似乎来自语言设置。例如请注意,维基百科的国家域名如何随语言设置、而不是 IP 地址变化。与此同时,IP 地址影响着顶部横幅中向用户展示的广告类型。因此,如果希望在 Google 上搜索时显得像来自另一国家,仅仅改变 IP 地址还不够;至少还必须相应改变语言设置。[21]
图中文字中文对照(中文版编排)
Internet:互联网
Web:网页
Billeder / Bilder:图片
Maps:地图
Indkøb / Shopping:购物
Videoer:视频
News:新闻
Mere / Mehr:更多
Søgeværktøjer / Suchoptionen:搜索工具/搜索选项
Ads:广告
Options:选项
OK:确定
Oversæt denne side / Diese Seite übersetzen:翻译此页
Wikipedia, den frie encyklopædi / Wikipedia, the free encyclopedia:维基百科,自由的百科全书
Cookies hjælper os med at levere vores tjenester. Ved at bruge vores tjenester accepterer du vores brug af cookies.:Cookie 帮助我们提供服务。使用我们的服务,即表示接受我们使用 Cookie。
Cookies helfen uns bei der Bereitstellung unserer Dienste. Durch die Nutzung unserer Dienste erklären Sie sich damit einverstanden, dass wir Cookies setzen.:Cookie 帮助我们提供服务。使用我们的服务,即表示同意我们设置 Cookie。
Få flere oplysninger / Weitere Informationen:了解更多
Tip: Søg kun efter danske resultater. Du kan angive dit søgesprog i Indstillinger:提示:只搜索丹麦语结果。可在“设置”中指定搜索语言。
Figure 3a: Search on Google.de, DK language, DK IP-address:图 3a:在 Google.de 搜索,丹麦语,丹麦 IP 地址
Figure 3b: Search on Google.de, DE language, DK IP-address:图 3b:在 Google.de 搜索,德语,丹麦 IP 地址
Figure 3c: Search on Google.de, DE language, DE IP-address:图 3c:在 Google.de 搜索,德语,德国 IP 地址
Figure 3d: Search on Google.de, DK language, DE IP-address:图 3d:在 Google.de 搜索,丹麦语,德国 IP 地址
Ca. 7.980.000 resultater (0,21 sekunder):约 7.980.000 条结果(0,21 秒)
Ungefähr 26.700.000 Ergebnisse (0,23 Sekunden):约 26.700.000 条结果(0,23 秒)
Ungefähr 7.870.000 Ergebnisse (0,26 Sekunden):约 7.870.000 条结果(0,26 秒)
Ca. 7.980.000 resultater (0,27 sekunder):约 7.980.000 条结果(0,27 秒)
10.000 kr. til NETTO!:10.000 克朗 NETTO 购物金!
Det store danske indkøbs-værdibevis slår til igen!:丹麦大型购物礼券再次登场!
♦ PLAY FOR FREE NOW ♦:♦ 现在免费玩 ♦
Play Your Favorite Game for FREE The best online game ever:免费玩您最喜爱的游戏:史上最棒的在线游戏
Download Movies (Free) ▼:下载电影(免费)▼
Access to Music and Movies Click here for free Access ▼:访问音乐和电影;点击这里免费访问 ▼
You may also be interested in felix baumgartner rekord, felix baumgartner jump, felix baumgartner live, felix baumgartner space jump.:您可能还感兴趣:felix baumgartner 纪录、felix baumgartner 跳伞、felix baumgartner 直播、felix baumgartner 太空跳伞。
Felix Baumgartner (født 20. april 1969 i Salzburg) er en østrigsk faldskærmsudspringer og BASE jumper. Han er berømt for en række spektakulære spring blandt …:Felix Baumgartner(1969 年 4 月 20 日生于萨尔茨堡)是奥地利高空跳伞及定点跳伞运动员。他因一系列壮观的跳伞而闻名,其中……
Red Bull Stratos - Rekorder - Privat - Citat:红牛平流层-纪录-私人生活-引言
↔ Boost Up Your Download!:↔ 加快下载速度!
Optimize & Boost PC in 1 Click. Fast, Easy, 5 Star User Rated!:一键优化并加速电脑。快捷、轻松,用户五星好评!
Click Here to be Answered:点击这里获得解答
Ask an Expert any Question and Get Trusted Answers Right Now ▼:向专家提任何问题,立即获得可信答案 ▼
Du har (3) videochats!:您有(3)个视频聊天!
Finde en kæreste i aften. Prøv First Date Gratis!:今晚找个恋人。免费试用 First Date!
You may also be interested in felix baumgartner facebook, felix baumgartner video, felix baumgartner gifta sax, felix baumgartner stratosphäre.:您可能还感兴趣:felix baumgartner facebook、felix baumgartner 视频、felix baumgartner gifta sax、felix baumgartner 平流层。
Intro - Felix Baumgartner:简介-Felix Baumgartner
Ready. Set. Go. EVERYTIME YOU GEAR UP IT IS LIFE OR DEATH. NOW PLAYING. FELIX. BAUMGARTNER. “LEARN TO LOVE WHAT YOU’VE.:准备。就位。出发。每当你穿戴装备,都关乎生死。正在播放。FELIX。BAUMGARTNER。“学会爱你已经。
Felix Baumgartner (* 20. April 1969 in Salzburg) ist ein österreichischer ehemaliger Base-Jumper und Extremsportler. Weltruhm erlangte Felix Baumgartner mit …:Felix Baumgartner(1969 年 4 月 20 日生于萨尔茨堡)是奥地利前定点跳伞及极限运动员。Felix Baumgartner 以……闻名全球。
Leben - Sprünge - Sonstiges - Auszeichnungen:生平-跳伞-其他-荣誉
murano due Wandleuchte Felix 47 P/PL:murano due 壁灯 Felix 47 P/PL
Moderne, unaufdringliche Pendelleuchte. Der besondere Reiz kommt durch die beso…:现代、不张扬的吊灯。其独特魅力来自特别……
Find felix baumgartner Now!:立即查找 felix baumgartner!
Update Your Video Plugin ▶:更新您的视频插件 ▶
See & Download Your Favorite Videos With VideoPerformer. It’s Free ✓:用 VideoPerformer 观看并下载您喜爱的视频。免费 ✓
Suchen Sie nach felix baumgartner:搜索 felix baumgartner
Erkunden Ergebnisse über felix baumgartner bei Ihrer Suche hierher.:在此搜索并探索有关 felix baumgartner 的结果。
Sie haben (1) Speed-Test:您有(1)个速度测试
PC optimieren&boosten mit 1 Klick. Schnell, leicht, 5-Sterne-Wertung!:一键优化并加速电脑。快捷、轻松,五星评价!
Født / Geboren:出生
Højde / Größe: 1,70 m:身高:1,70 米
Forældre / Eltern:父母
Søskende / Geschwister:兄弟姐妹
Relaterede søg… / Wird auch oft g…:相关搜索……/也经常被搜……
图 3 按两列、两行排列,依次为左上 3a、右上 3b、左下 3c、右下 3d;各面板保留原搜索字符串、语言设置与 IP 地址条件。右侧知识面板在原图中被裁切,中文对照仅覆盖可辨识的内容,不补全被裁去的文字。
〔原图局部文字存在分辨率、裁切或遮挡限制;译文保留可辨识范围,不补写未出现内容。〕
个性化——搜索中已知的未知
除了关键词选择、语言设置和基于位置的结果之外,当然还有日益被“黑箱化”的个性化问题。早些时候,许多研究试图通过系统记录不同查询中的搜索排名,来“揣测”Google 的搜索算法。[22] 近年来,人们越来越清楚:对于任何给定查询,影响搜索结果具体构成的因素众多,[23] 再加上日益增强的用户个性化, 使这项任务即便不是不可能,也变得极其困难。[24] 根本不存在一个能让研究者客观分析搜索结果的制高点。我们知道结果经过了个性化处理(部分因为 Google 一再证实了这一点),[25] 却不知道确切的处理方式。这一事实迫使学者放弃这些严格的定量设计,要么彻底放弃搜索研究(我感觉相当多人已经如此选择),要么在研究中主动面对这些限制。
Richard Rogers 等人提出过一种减轻个性化影响的方法。Rogers 建议研究者使用“研究浏览器”,也就是清除了所有使用历史、每次打开都从零启动的浏览器。[26] 另一种常见做法,是使用某种 IP 地址扰乱工具:将 IP 地址换成随机或指定地址(例如通过 VPN 服务器),或者隐藏 IP 地址(例如通过 TOR)。两种方法肯定都能用于处理个性化问题(更不用说监控问题),因为它们让人更容易扰乱某些影响搜索引擎的因素。不过在我看来,从研究角度,它们也有一个缺点:可能过于人为,脱离真实世界中的搜索情境。多数人在搜索时,要么已经(有意或无意地)登录 Google,要么不会为了避免过去的搜索历史影响当前结果,而每次都更换 IP 地址。因此,采用这种方法或许能够剥离搜索引擎的某些个性化因素,让不同研究者得到更稳定的搜索结果。这些结果可能具有信度,却未必很有效度。
另一种方式是放弃严格的信度观念,更多地把搜索结果当作服务于定性研究的文档,而不是统计研究中的精确数据点。这样,也许更适合用“可信性、严谨性和质量”[27] 来讨论这类文档的科学价值,并在不同搜索者之间对查询进行三角互证(过程中也可让人作为参与者加入)。依照这些标准,我们能否以更细致的方式,恰当地讨论搜索结果的变化?当然,仍然几乎不可能判断:搜索结果的哪些变化来自个性化,哪些来自算法中包含的其他无数因素,例如 A/B 测试和结果随机化。但评估这些变化,也不会是这类研究的目标。把搜索结果视为历史文档——由研究路径中带有或多或少明确偏向的研究者,在某个特定时间和地点归档(在这里,偏向具体体现为个性化机制)——它们就与我们能够接触到的任何其他类型 资料处在同一层面。资料可以照亮某种历史情境或某个时期的新侧面,却永远无法完整再现研究对象。资料(如同数据)永远不能自己说话。
简言之,由于这里展示的种种归档挑战,揣测 Google 恐怕并非研究应该采取的方向。相反,我们应当把搜索结果用于不同的目的,并将其放在其他现有信息的语境中。
那么,接下来呢……?
历史学家都知道,依赖单一资料是一件充满偶然性的事,可能导向危险的结论(谁能保证这个单一资料愿意或能够讲出真相?)。搜索结果也是如此,无论它们是为记录某个事件而在短时间内密集收集,还是为纵向研究而在较长时期内收集。单独来看,它们难以验证,因此几乎无法系统分析。但是,与其他资料(如报纸文章、社交网站活动、电视报道等)结合之后,它们能够使社会发展和重大事件的某些侧面显现出来,否则这些侧面便会继续隐藏在暗处。正如前文提到的惊人渗透率所表明的,Google 仍是许多人进入网络的主要入口之一,因此能够成为观察某个时代心态的重要透镜。正因如此,有必要保存搜索结果,使其能够供未来研究使用。
在讨论在线归档涉及的各种方法论挑战时,我提出了一些前进方向。更连贯地概括起来,我的建议如下:无论是开展纵向研究,还是采用短期密集模型,都应比较(或三角互证)不同参与者的结果。这些参与者最好位于不同地理位置,采用相应的语言设置,并且使用 IP 地址不与个别计算机绑定的、或多或少匿名的网络,或使用参与者自己的计算机。如果使用个人计算机上的浏览器,那么对人类参与者进行抽样的标准便是研究设置不可分割的一部分。这意味着,研究者在评估搜索结果时,除其他因素之外,还必须考虑参与者的年龄、性别、居住地和搜索习惯等个人特征。[28] 一种可行的设计是采用“最大差异抽样策略”,[29] 研究者据此尝试按照规定标准,组成一个特征尽可能各不相同的参与者群体。如果这个群体得到的搜索结果差异很小,就能够更有力地证明这些特定结果具有一致性。因此,这种档案研究路径与许多传统定性研究设计相似。
如果有可靠的 VPN 服务器,则可以通过改变 IP 地址和语言设置来进行地理分层,而不必依赖人类参与者。这确实是一种更方便的解决方案(只用一台计算机就能完成,而且可以自己控制归档的所有方面),所以对多数独立研究者而言,它大概更可行。但是根据我的经验,很难保证这种做法在实践中奏效。我仍然认为,组织一组真人搜索者优于这一方案,因为这能让我们更细致、也更富分析成果地讨论不同个人画像之间搜索结果的差别。
最后补充一点:我在这里围绕 Google 讨论的个性化问题,似乎正在迅速扩散到新的领域,例如新闻网站。《赫芬顿邮报》已经使用由算法驱动的首页,根据用户(被感知到的)兴趣作出调整。[30] 这对开展内容分析的学者构成明显挑战,也让更大范围的在线研究无法回避这一难题。如果我们还希望继续归档和分析在线内容,就必须面对它。唯一真正的解决办法,似乎是让研究设计适应材料的局限,并接纳我们作为研究者不得不接受的不确定性。我在本文中提出了一种做法。也许,其他人能够把火炬传得更远一些。
参考文献
Blake, Thomas, Chris Nosko, and Steven Tadelis. ‘Consumer Heterogeneity and Paid Search Effectiveness: A Large Scale Field Experiment’, The National Bureau of Economic Research Working Paper, 6 March 2013, http://conference.nber.org/confer/2013/EoDs13/Tadelis.pdf.
Dayan, Daniel and Elihu Katz. Media Events: The Live Broadcasting of History, Cambridge, Mass.: Harvard University Press, 1992.
Edelman, Benjamin. ‘Hard-Coding Bias in Google “Algorithmic” Search Results,’ 15 November 2010, http://www.benedelman.org/hardcoding/
Feuz, Martin, Matthew Fuller, and Felix Stalder. ‘Personal Web Searching in the Age of Semantic Capitalism: Diagnosing the Mechanisms of Personalisation’, First Monday 16.2 (1 February 2011).
Fishman, Rob. ‘Stories You Might Like: Join Our Beta Program to Test HuffPost Recommendations’, The Huffington Post, 6 January 2011, http://www.huffingtonpost.com/rob-fishman/stories-you-might-like-jo_b_800427.html.
Golafshani, Nahid. ‘Understanding Reliability and Validity in Qualitative Research’, The Qualitative Report 8.4 (2003): 597-607.
Granka, Laura A. ‘The Politics of Search: A Decade Retrospective’, The Information Society 26.5 (September 27, 2010): 364-374.
Hillis, Ken, Michael Petit, and Kylie Jarrett. Google and the Culture of Search, New York, NY and Oxon, UK: Routledge, 2013.
Iorga, Catalina, ‘Erik Borra and René König Show Google Search Perspectives on 9/11’, Institute of Network Cultures, 11 November 2013, http://networkcultures.org/wpmu/query/2013/11/11/erik-borra-and-rene-konig-google-search-perspectives-on-911/.
Jensen, Klaus Bruhn. ‘Meta-Media and Meta-Communication: Revisiting the Concept of Genre in the Digital Media Environment’, MedieKultur. Journal of Media and Communication Research 51 (2011): 8-21.
———. ‘New Media, Old Methods – Internet Methodologies and the Online/Offline Divide’, in Mia Consalvo and Charles Ess (eds) The Handbook of Internet Studies, Oxford, UK: Wiley-Blackwell, 2010.
Kuzel, Anton J, ‘Sampling in Qualitative Inquiry’, in Benjamin F. Crabtree and William L. Miller (eds) Doing Qualitative Research, Thousand Oaks, CA: Sage Publications, Inc, 1992, pp. 31-44.
Levitt, Steven D. and John A. List, ‘Was There Really a Hawthorne Effect at the Hawthorne Plant? An Analysis of the Original Illumination Experiments’, American Economic Journal: Applied Economics. American Economic Association 3.1 (January 2011): 224-238, http://www.nber.org/papers/w15016.
Lewandowski, Dirk. ‘Web Searching, Search Engines and Information Retrieval’, Information Services & Use 25 (2005): 137-147.
Marres, Noortje and Esther Weltevrede, ‘Scraping the Social? Issues in Real-Time Social Research’, Journal of Cultural Economy 6.3 (2012): 313-335.
Pariser, Eli. The Filter Bubble: How the New Personalized Web Is Changing What We Read and How We Think, New York, NY: Penguin Books, 2012.
Rogers, Richard. Digital Methods, Cambridge, Mass.: MIT Press, 2013.
Sanz, Esteve and Juraj Stancik. ‘Your Search – “Ontological Security” – Matched 111,000 Documents: An Empirical Substantiation of the Cultural Dimension of Online Search’, New Media & Society (29 April 2013): 0-19.
Zuckerman, Ethan. ‘In Soviet Russia, Google Researches You!’, …My Heart’s in Accra blog, 24 March 2011, http://www.ethanzuckerman.com/blog/2011/03/24/in-soviet-russia-google-researches-you/.