搜索教育:理解过去与当下的搜索技术,培养面向未来的适应力
这个段落位置已不存在。请使用目录或当前章节查找内容。
Dave Crusoe
搜索教育:理解过去与当下的搜索技术,培养面向未来的适应力
Dave Crusoe
是谁教会了你网络搜索?你还记得学过什么?我在 20 世纪 90 年代中期上高中时,第一次正式接触网络搜索。当时老师教我把搜索理解为一种挖掘资源的方法:资源包含或排除某些特定特征。我的学习与集合论和布尔代数相连,它们提供视觉、数学及概念语言,让我们能够阐明对象之间的关系。例如,我们可以用维恩图在视觉上区分甜的与酸的水果,或者把兼有酸甜特征的水果与其他水果区分开。在美国,学生通常在初中阶段接触维恩图。较复杂的布尔代数,例如书面符号表示,则可能出现在高中数学课上。[1]
计算机科学家为了应对数字信息的庞大规模与混乱所带来的问题,采纳并运用了布尔代数和集合论的核心原则。早期搜索先驱及后来的开发者,都曾运用布尔代数逻辑,帮助用户和软件识别相关信息。例如,早期搜索引擎要求用户按字面使用布尔逻辑来定义查询。Excite.com 搜索引擎曾允许搜索者使用 AND、OR、AND NOT 逻辑,甚至可以用圆括号将词语组合起来,规定处理词语的优先顺序。[2]
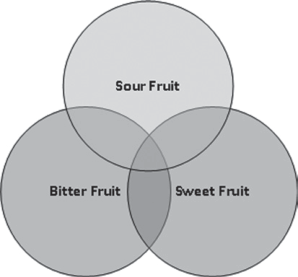
图中文字中文对照(中文版编排)
Sour Fruit:酸味水果
Bitter Fruit:苦味水果
Sweet Fruit:甜味水果
这种共生关系——搜索逻辑、搜索引擎功能与教育之间的关系——造成了一种局面:集合论及某些布尔概念,与搜索引擎操作一同教授。结果是,关于搜索逻辑的教育,包括关键词结构与语法,呈现了搜索引擎如何运作的错误概念 图景;而与此同时,常见搜索引擎的功能已经越来越少依赖显式的代数运算,越来越取决于用户如何利用已有知识,构造、操纵并改述一系列查询。
我观察过美国初高中若干专门教学生网络搜索的课堂,发现教育者对于搜索引擎运作的理解,常常反映的是更早的、或另一个时代的情况。因此,我认为,教育者会受益于一份简明而整体的说明:搜索引擎在历史上如何运作,又如何因若干迫切的信息挑战而演变;以及随着技术变化,教学为什么必须从讲授逻辑转向讲授搜索功能和实践。我希望,这一过程能够让教育者就我们所提供的专题教育的本质,产生认知失调,从而促成更有力的教育体验。
起点:数字空间中的布尔逻辑
要富有成效地讨论数字空间中的布尔逻辑应用,重要的是先对布尔代数究竟是什么、其逻辑如何运作,形成共同理解。布尔代数包含许多我们每天使用的熟悉概念、语言和符号工具,例如 AND、OR、NOT。它们可以用语言表达(“AND”)、用符号表达(∧ 表示 AND),也可以在程序中表达(许多编程语言使用“&”)。
还有若干逻辑运算,除程序员以外的人可能不太熟悉。一些搜索引擎可能仍使用优先级分组,也就是我们熟悉的括号 ( 和 )。括号允许某些集合运算先于其他运算执行。另一种运算是逻辑析取(“XOR”,符号写作 ⊕),它表示:如果 A 或 B 为真、但二者不同时为真,运算便判定为真。[译注:原文称 logical disjunction(逻辑析取),但这里的 XOR 符号及真值条件指异或,即排他性析取。]布尔代数还包含等价、重言式和矛盾式等逻辑结构。不过,多数搜索引擎面向用户的语法,在技术能力上不及完整布尔代数的真正语法。例如,我们进行搜索时,可能会使用:
- AND:“合取”意味着关键词之间存在必要关系,即在列出第一个词的结果中,后续词也必须出现。例如,显示所有 [sweet AND sour](甜并且酸)的水果。
- 隐含的 AND:如果 AND 是隐含的,关键词便由隐含的合取关系相连。例如,用隐含的 AND 解析 [sweet sour],会将其识别为 [sweet AND sour]。
- 隐含短语:另一种解释关键词的方法,是将其视为隐含短语。为了搜索匹配,查询中的多个关键词被转换为一个明确的短语。例如,如果 [sweet salty sour] 被当作隐含短语,返回的结果就会按这一顺序连续包含“sweet salty sour”这几个确切的词。
- 精确短语:为搜索匹配而明确指定一个短语。
然而,根据搜索引擎的不同,我们使用的语法对于结果的影响,也会随着开发者对引擎行为的规定而变化。例如,多年来,如果输入的关键词并非一个短语,Google 就会在它们之间使用隐含的“AND”。根据网上的讨论,如今已不再如此。[3]
把提供给我们的语法看作一系列解释中的一层,会有所帮助。程序员向用户提供布尔功能,在管理输入(我们提供的内容)与输出(为了提供结果,他们必须指示引擎完成的操作)之间的沟通时,对这些功能进行解释。例如,假设我们在一个简单的文学数据库中搜索 Jules Verne 的书。当查询被直接转换成流行的数据库引擎 MySQL 的形式时,可能看起来像这样:
Select title,year,dewey-id from books where author = (Jules Verne AND language = English)
这里,我们要求数据库从一个图书表中,返回作者为 Jules Verne、语言为英语的图书的书名、年份和杜威十进分类信息。不过,搜索引擎创建者发现,相关或相似的结果也可能有用,却没有被字面查询包括进来。因此,我们输入的搜索还会受到进一步解释。设想我们搜索 Jules Verne 的一本书,却把他的名字误拼为“Julez Vern”。程序员设计的算法,不仅展示所有严格匹配的结果,还展示读音相同的匹配项。算法会自动将查询转换为类似这样的形式:
Select title,year,dewey-id from big-search-database where SOUNDEX(author) = SOUNDEX(Julez Vern)
当然,这极度简化了搜索引擎定位信息的方式,但能够说明:我们用简单词语表达的查询,如何演变为搜索引擎运营者可能用来生成和呈现结果的查询。理解这一转变,就为我们探索那些压力奠定了良好基础;这些压力迫使信息寻求实践与搜索之间的关系超越“布尔”阶段。下一节将考察这些压力。[4]
演变:“做得更好”的压力
任何搜索引擎最根本的目标,或许都是迅速向用户提供能够准确回应其信息需求的高质量内容。为了实现这一点,主要搜索技术把各种挑战拆分给彼此独立而又相互连接的系统。查询页面帮助并引导用户创建准确的查询,供引擎解析。查询引擎探查索引,以识别各条结果;索引由索引引擎构建,而索引引擎通常分布在数十、数百或数千台机器上。索引引擎则利用爬虫提供的输入建立结果,爬虫负责识别、获取内容并将其送入索引。 在这一过程的每一步,各种算法都会从不同的质量维度,对内容进行排序、赋予权重、判断和审查。每一步都有内外部压力推动技术演变。最重要的因素也许是经济因素——商业上的迫切需要。如果用户不满意,他或她就会到别处搜索。[5] 但这些压力主要仍是技术性的。
一种主要压力,是消除垃圾信息的需要。搜索工程师面临双重任务:一方面立即呈现与查询相关的文档,另一方面减少或消除那些通过搜索引擎优化技术、使索引算法误以为相关的文档。搜索引擎优化(SEO)是人为提升网站排名或评级、以增加流量的实践。搜索引擎创建工作的核心挑战,不仅是判断什么合法正当,还要判断什么相关、什么质量高。可以预期,对于任何一次搜索,都有相当一部分内容因为可能是垃圾信息而被排除。
另一方面,还有许多提供高质量信息的网站或资源,完全没有进行过任何优化,因此很难、甚至不可能被发现。出版物,尤其是数字化以前出版的内容,或位于付费墙后的内容,是十分常见的例子。历史研究或讨论,包括通过网络前身 Gopher 发布的材料,也隐藏在搜索引擎的视野之外。同样,并非所有讨论论坛都完全公开。某些微型社群,例如 Howard Rheingold 的 Brainstorms 电子公告板系统,只能通过会员程序访问;该系统已经支持了十五年关于技术未来的讨论。这类重要材料可以归入“深层”网络。
无论如何,重要的是要理解:搜索引擎提供者努力平衡所提供的结果,以便对任何查询都尽量减少“垃圾”返回项、尽量增加高质量结果。他们的工作意味着,某些内容在给定搜索中可能出现,也可能不出现。另一种压力是确保新鲜度。新鲜度关乎内容的新旧,取决于爬取到的项目能够多快被索引,并通过搜索结果向搜索者开放。随着技术改进,新鲜度不断提高。[6] 例如,用户访问网站时,期待找到最新新闻文章或网站的最新版本。与垃圾信息过滤一样,内容也会按新鲜度过滤。例如,当出现更新的新闻文章时,某一篇文章可能就不再出现在第一或第二页结果中。另一种情形是,一篇特别受欢迎的旧文章,可能排在新得多的新闻或内容之前。
除了提供没有垃圾信息且新鲜的结果之外,搜索引擎提供者还希望理解查询背后的意图。用户进行的是导航式查询(例如寻找 某个特定网站)、信息式查询(“获取被认为存在于一个或多个网页上的某些信息”),还是事务式查询(“进行某种以网络为中介的活动”)?[7] 提供符合用户愿望的结果,会使顾客满意并愿意再次使用。
在 2011 年向美国国会作证时,Google 首席执行官 Eric Schmidt 表示,2010 年公司进行了数千次算法微调,最终实施了“516 项修改”,以提高搜索质量。[8] 如此之多的修改,实际上确保了搜索结果会随时间变化。这重要吗?我认为重要,而且我们必须把搜索引擎看作活跃、经常演变的工具,而非稳定不变的技术。我们获取的内容经过过滤和排序,未必涵盖一个主题的全部可知信息;即便获取到了某些内容,它们也不会长久保持不变。这些变化悄然发生,并不明显。
然而,一项最深刻的进步,与垃圾信息过滤、速度、新鲜度,乃至内容排序算法都没有关系。它关乎提供者希望读出远远超越用户简单文字查询的东西——搜索提供者想理解并解释用户真正想知道什么。用来描绘这种意图的东西,被称为“信号”。
结果:从解释查询到解释意图
2002 年,一个研究团队在讨论搜索的未来时提出:“我们需要新一代网络搜索工具,以更深入理解人类的信息行为为基础。这些工具将帮助用户构建和修改查询、处理拼写问题,以及解决那些限制其能力或意愿、使其无法坚持寻找所需信息的分析性问题。”[9] 十年之后,形式意义上的查询依然重要,它仍是搜索引擎揣测搜索者需求的主要方式。那么,查询是什么?查询的文字,只是我们可以视为完整请求的一小部分。查询结合了搜索者是谁、身在何处、要求引擎获取什么,以及过去可能告诉过引擎什么。[10] 这些都是“信号”;搜索引擎越来越多地收集信号,以解释用户意图。
地理空间参照信息——位置——是一种强有力的信号,对许多商业查询尤其如此。例如,一个对电影场次感兴趣的搜索者,可能其实希望查询自己当前所在地的电影场次。当我在搜索栏输入“movie time”时,会收到一个建议:“‘movie time’ atlanta”,而亚特兰大正是我当下所在之处。如果我想查纽约的电影场次,就必须把查询写得更具体。
有些搜索引擎还会利用搜索历史,预测我们希望从当前或未来搜索中获得什么信息。如果我正在研究某个历史人物,这种定制也许有用,尤其是它能帮助我细化关键词(即输入的语法)时。例如,Google:
[…] 如今在评估网站质量与相关性时,会考虑 200 多项因素。当用户在 Google 搜索中输入查询时,Google 的专有技术会分析这些信号,判断用户在寻找什么。Google 使用这种不断改进的技术来组织信息、排列网站,并向用户呈现结果。Google 的搜索结果,归根结底是对用户会认为什么信息最有用的一种科学性意见。[11] [强调为引者所加]
我们可以据此理解:无论通过键入、说话,还是其他方式表达查询,所使用的语言未必会按字面得到解释。搜索引擎会考虑多种语言手段,更好地使我们的意图与高质量结果匹配。例如,词干处理会把“child’s”与“children’s”相匹配,或者将“runner”与“run”和“running”匹配。因此,搜索一个词可能会得到其他十分相近的词干形式。此外,引擎还可能匹配同义词。搜索“stationary”,也可能得到关于“office supplies”(办公用品)和“staples”(订书钉)的信息,因为这些是普遍使用、意思相近的词。[12][13]
布尔语法的应用方式也正在改变,尽管语法语言本身没有变化。到这里,我们已经熟悉 AND、NOT 和 OR 这些基本布尔搜索运算符。搜索引擎提供者经常修改这些运算符与搜索技术互动、显示匹配结果的方式。例如,直到 2011 年秋,Google 搜索软件还使用 AND 连接关键词,并使用“+”表示必需且精确的关键词。[14] 到 2011 年秋,语法发生演变,隐含 AND 的使用减少,“+”运算符改成了引号“”。此外,只有通过 Verbatim(逐字搜索)工具,才能获得对查询的精确回应;这个工具“使用您键入的确切关键词”提供结果。[15] 通过标准工具进行的查询,则可能包含没有由 AND 或 + 语法明确指定的项目。[16]
在写这篇文章时,我还惊讶地发现,Google 对沿用已久、要求精确短语匹配的引号语法“”的解释, 其实际应用也可能正在改变。如今,这些搜索会返回在短语各部分之间插入字符的结果(“standardization test”会匹配“standardization: test”);使用单数、复数或被动语态的搜索,也会返回某些“纠正过”的结果(“world serie”返回“world series”的结果)。自动纠错也会被强制执行。使用 Google 标准工具精确搜索“thsi American life”,会返回“This American Life”的结果;但使用 Google 的 Verbatim 工具搜索同一错误短语,所得结果集明显不同。作为比较,Bing 的搜索结果也采用了类似的精确短语自动纠错方式。在 Bing 搜索“literar device”,只会返回“literary device”的结果,尽管 Bing 的语法指南说,引号应当返回“包含指定短语、完全一致”的结果。[17]
对地理位置的日益重视、模糊匹配和同义词使用的增加、索引快速更新,以及对我们精确语法的解释方式不断演变,都表明查询语法的性质正在改变。我们的搜索不再仅仅关乎输入的关键词。它就是对我们发送给引擎的全部信号总和的解释。总之,我们必须把查询看作向引擎发送的所有信号的总和,而非仅仅是键入搜索框的词语。
信号世界中的搜索教育
为了回应这些变化,搜索教育必须聚焦适切、高价值的内容,引导学习者形成能够回应技术变化、并具有适应力的理解。教学时间最应该花在哪里?
第一:教授搜索引擎如何运作
首先,也最根本的是,搜索者需要基本理解搜索引擎是什么、如何运作。必须告诉他们:搜索引擎可能爬取了我们所理解的互联网中很大一部分,但并非所有部分都能通过我们的搜索显现出来。引擎的解析或排序可能有益,例如过滤垃圾信息,但也可能有害。在哪些情况下它有害?有什么办法可以克服人为障碍?搜索引擎中可能内置哪些工具,让搜索者更充分利用技术所提供的能力?通过帮助学习者理解搜索引擎是什么、如何运作,以及如何、到哪里进一步了解它,我们便为他们提供了工具,使他们更容易适应意料之外的情况。
第二:教学习者使用可能出现在网页中的关键词、短语或句子
在主要搜索引擎中,关键词是用户向引擎传达的主要信号,用来驱动结果产生。但对某个具体搜索而言,应该用哪些关键词?我们如何知道?在某些引擎中,尤其是 EBSCO 等学术搜索引擎中,关键词可能必须匹配与某篇文章或某个特定条目字段有关的预定义关键词。[18] 但在使用主要搜索技术时,这些关键词与搜索成功之间的关联 越来越弱。对于 Google 等提供者,更重要的是让关键词或短语瞄准网页可能使用的语言,甚至试着复现某个页面可能出现的一句话。
这对于教授 AND、OR、NOT 等布尔关键词意味着什么?作为教育者,向年轻人教授特定关键词语法的重要性日益下降,教授搜索引擎承担的整体技术功能,则重要得多。
第三:教授耐心与细化
教育者还必须教授耐心。我和一些教育同行把它称为“细化思维”。[19] 搜索者经常选择页面前四个选项中的一个,但前四个中某一项恰好是“最佳”或“唯一”答案的情况,要少见得多。社会心理学家把这称为“认知吝啬”,“基本意思是,如果没有必要,人们不愿意费太多心思去思考”。[20] 然而,这是一个必须改掉的重要习惯,尤其因为那条捷径实在太快了。你有多常观察到同样的做法?你如何回应,又可以怎样改进?
一种良好的回应,是让学习者积极参与讨论,分析某一来源信息的优缺点,并要求他们综合多个来源的信息。不过,不要把它当成一个被动任务,只按引用来源的数量评分。相反,要让他们展开说明并认真思考:这些来源怎样相互印证,又在哪里存在差异?哪些来源似乎质量更高,为什么?从这项知识中,可以汲取什么用于今后的研究?这些都是值得向学习者提出的问题。
最后,对于年龄较大的学习者,我们至少必须提及必要的“代码转换”:要从成功搜索复杂网络引擎的方式,转向图书馆和研究数据库使用的简单得多的搜索技术。研究数据库经常使用显式的布尔运算符。能够熟练操作这些数据库,是中学和高等教育学生的一项基本技能。但我们必须认识并区分:要在一种“代码”——网络引擎——中取得成功,与在另一种、较旧的布尔数据库中取得成功,需要不同的教学。
第四:教授内容来源知识
任何讨论,如果不传达识别高质量来源的重要性,都不能算完整。高质量信息来源提供的审查程度,以及可能包含的细节,都超过许多随手可得的来源。例如,搜索“how a cat purrs”(猫如何发出呼噜声),会得到大量结果,其来源包括内容聚合网站(http://ask.com 和 http://answers.com)、政府网站(http://www.loc.gov,美国国会图书馆)以及出版物(例如 《科学美国人》)——这些全都出现在 Google 最前面的十几个结果中。结果的内容及可能的质量,如同来源本身一样多样。但了解并理解哪些地方最可能提供细致、高质量的内容(例如国会图书馆或《科学美国人》),很重要。
然而,我们必须问:学习者如何学会辨认哪些来源质量最高,哪些来源质量可疑?在学校?在家里?确保年轻人能够识别少数几个高质量资源,是谁的责任?我认为,作为教育者,这是我们的责任。一位兼任教育者的图书馆员最近对我说,她希望学科教师不仅为课堂作业评分,还应评价学习者为报告获取信息时所用资源的总体质量。此外,如果有一项作业,是改善已经找出的资源,又会怎样?也许,作为教育者,我们可以更努力地让学习者批评自己的来源,而且从更小的年龄就开始。
结论
过去十年,搜索引擎技术复杂精进的程度已经难以衡量。随着更复杂的范式出现,一度有用的范式——包括把布尔逻辑当作搜索工具的用户范式——其重要性已逐渐下降。撰写本文时,我希望为理解搜索引擎的功能,以及搜索提供者所面临的挑战,奠定基础。我相信,通过对这些挑战形成共同理解与尊重,我们能为自己站稳脚跟,并引导学习者理解同样的问题。
但事情还不止于此。我希望,本文已经促使人们思考:当搜索技术本身已经超越我们曾学过的那些直接而合乎逻辑的工具时,搜索教育应如何开展。我们许多教育者都必须更新“教授搜索意味着什么”的概念理解。今天要教搜索,最好教授搜索引擎实际如何运作。它们发现——即“索引”——什么,为什么?在过程中遗漏了什么?有了这种理解,就很容易继续解释,为什么耐心、即“细化思维”,是一项重要实践。不过,除非教育者对学生付出更多关心,否则这种实践不会扎根:我们不仅要教他们如何综合信息,介绍可信且可引用的来源,还要帮助他们批评已经找到的来源。总体而言,如果真正掌握这些实践,未来的研究者就能在当下蓬勃发展,并在不可避免的技术演变中保持适应力。
特别感谢 IBM Research 的 Mary Roth 与 OnCUE 的 Sara Armstrong 提供反馈。
参考文献
Broder, Andrei. ‘A Taxonomy of Web Search’, ACM Sigir Forum 36.2 (2002): 3-10.
EBSCO, ‘Advanced Search Guided-Style Find Fields – Help Sheet’, http://support.epnet.com/knowledge_base/detail.php?id=3821.
EBSCO, ‘Searching with Boolean Operators – Help Sheet’, http://support.ebsco.com/knowledge_base/detail.php?id=3883.
Fiske, Susan T. ‘Social Cognition’, in Abraham Tesser (ed.) Advanced Social Psychology, New York: McGraw-Hill, 1995, pp. 145-194.
Fox, Vanessa. ‘Google’s New Indexing Structure “Caffeine” Now Live’, Search Engine Land weblog, 8 June 2010, http://searchengineland.com/googles-new-indexing-infrastructure-caffeine-now-live-43891.
_____. ‘Is Google’s Synonym Matching Increasing? How Searchers and Brands Can Be Both Helped and Hurt by Evolving Understanding Of Intent’, Search Engine Land weblog, 27 August 2012, http://searchengineland.com/is-googles-synonym-matching-increasing-how-searchers-and-brands-can-be-both-helped-and-hurt-131504.
Google. ‘Search for Exact Words or Phrases’, http://support.google.com/websearch/bin/answer.py?hl=en&p=g_verb&answer=1734130.
_____. ‘Verbatim Tool’, http://support.google.com/websearch/bin/answer.py?hl=en&p=g_verb&answer=1734130.
Hu, Victor, Maria Stone, Jane Pedersen, and Ryen W. White. ‘Effects of Search Success on Search Engine Re-Use’, in Bettina Berendt, Arjen de Vries, Wenfei Fan, Craig Macdonald, Iadh Ounis, and Ian Ruthven (eds) Proceedings of the 20th ACM International Conference on Information and Knowledge Management (CIKM, ’11), New York: ACM, 2011, pp. 1841-1846.
Schmidt, Eric. ‘Testimony of Eric Schmidt, Executive Chairman, Google Inc. before the Senate Committee on Judiciary Subcommittee on the Antitrust, Competition Policy and Consumer Rights’ 21 September 2001, http://searchengineland.com/figz/wp-content/seloads/2011/09/Eric-Schmidt-Testimony.pdf.
Schwartz, Barry. ‘Google Removes the + Search Command’, Search Engine Land weblog, 24 October 2011, http://searchengineland.com/google-sunsets-search-operator-98189.
Spink, Amanda, Bernard J. Jansen, Dietmar Wolfram, and Tefko Saracevic. ‘From E-Sex to E-Commerce: Web Search Changes’, IEEE Computer, 35.3 (2002): 107-109.
Stuart, Anthony. ‘Re: Boolean + Operator Removed? Why?’ posting to Google Search Forum, 5 November 2011, http://productforums.google.com/forum/#!searchin/websearch/%22implied$20and%22/websearch/3oIWbew9xdE/xuKBfNk5wjwJ.
Way Back Machine, 21 November 1996, archive of ‘How to Use Excite Search’, http://web.archive.org/web/19961219003220/http://www.excite.com/Info/advanced.html?aqt.