算法化算法
这个段落位置已不存在。请使用目录或当前章节查找内容。
Martina Mahnke 与 Emma Uprichard
算法化算法
Martina Mahnke 与 Emma Uprichard
#hello(你好)
想象你正航行在大洋之上。阳光灿烂,四周辽阔。忽然[砰],你撞上了一堵看不见的墙。欢迎来到《楚门的世界》!自 Eli Pariser 发表关于潜在过滤气泡的思考以来,[1] 这个电影情景似乎变成了现实,只稍有不同:我们说的不是海洋,而是互联网;构成那堵隐形墙的,也不是电视节目制作人,而是算法。[2] 基于这一假设,多数研究试图“驯服算法这只老虎”。[3] 这是一种有价值、也常常富于启发的路径,但我们想强调算法日常生活的另一面。我们认为,算法可以激发并促进想象、创造力与嬉闹;它说出的东西,同时既旧又新,总是几乎重复过去,却又从未完全回返。我们把富于启发的引文,与 Google 自动补全算法的截图串联起来,展示这一点。借此,我们邀请读者以创造性、游戏性和反思性的方式重新探索 Google 的自动补全算法,让我们成为、并不断成为算法日常生活那谜一般的节奏的一部分时,所获得的兴奋与嬉闹,更加显而易见。
#warning(提醒)
我们采用了一种不同寻常的文字风格,可能令某些读者恼火、困惑,但希望也能使另一些读者愉悦、好奇。因此,我们让讨论保持相对简短,并有意带些挑衅。不过,我们不想把人弄糊涂或激怒,以致什么也听不进去。我们的目的,并非为了搅乱学术文字的 重要性而搅乱。相反,我们所做的是一种实验,映照出我们通过算法相连、穿行于新旧媒体空间的旅程中,那些意外的落点、自发性,以及偶尔的疯狂。
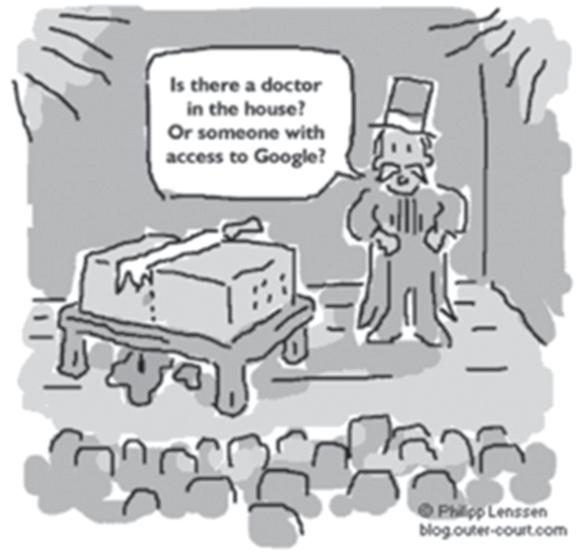
图中文字中文对照(中文版编排)
Is there a doctor in the house? Or someone with access to Google?:现场有医生吗?或者,有谁能上 Google?
© Philipp Lenssen
blog.outer-court.com
漫画署名:© Philipp Lenssen;Cartoon by Google Blogoscoped。
#searching(搜索)
一般而言,搜索引擎,尤其是 Google,已经成为互联网的入口。我们用 Google 验证信息、验证可信度、验证存在。Google 仿佛能够回答一切问题。“我 Google,故我在”?René Descartes 曾试图通过彻底怀疑自身存在来证明存在;如今,经由 Google 获得可见性,却被用作证明。Google 似乎无所不知、无所不在。Google 是新的上帝吗?“Google 教会”试图通过科学推理寻求证据,得出结论:“我们 Google 教会相信,搜索引擎 Google 是人类迄今最接近直接体验真实上帝的东西。”[4] “Google 一下”已经成为今天搜索网络的同义语,尽管官方语言委员会并不赞同这一趋势。有时,很难想象没有 Google 的生活会怎样。我们会做什么?使用另一个搜索引擎?不再关心互联网信息?
试着回答这些问题,尽管是假设性的问题,会使我们得出结论:Google 不只是一个工具,它还是现代神话。但别忘了,Google 同时仍然“只是”搜索引擎。从市场营销视角,搜索引擎的发展可以分为三个时期:[5] (1)1994 至 1997 年的“技术创业者”时期;(2)1997 至 2001 年的“门户与纵向整合”时期;(3)2002 年开始、 延续至今的“联合分发与整合”时期。Google 在第二阶段的 1998 年推出了革命性的新搜索算法。[6] Google 的自动补全功能于 2009 年 4 月 1 日推出,我们的讨论将聚焦于这种自动补全算法。
我们的目的,不是细致批评这个主题已有的文献。[7] 相反,我们想提供另一种思考搜索的方式,映照出某种“jagged-jixie”式的参差跳动:当我们随意上网、探索、搜索,找到(并不)新鲜的材料、(并不)新的朋友和(并不)新的同事时,我们始终经由算法、并与算法交谈。我们希望为当前关于算法社会影响的讨论作出贡献。毕竟,算法根本上是社会性的——它们由社会建构,其意义随时间和空间而变化。算法充满伦理与政治问题;它们把已经相互连接的事物连接或断开,而能够将其释放出来的,仅是极少数具有权力和技术专长的人。所以,是的,我们知道并同意:算法拥有权力,也进行治理,正如许多现有文献所论证的。然而,如果我们允许,算法也能激发想象、创造力与嬉闹。突然之间,我们也许会发现:一旦开始玩耍,它们的权力就可以改变。
#perspectives(视角)
从数学视角看,算法已经存在数百年。正如 Chabert 用简单语言概括的,[8] 算法就是配方或逐步指令。巴比伦人用算法裁定法律问题,拉丁语教师用算法教授语法。今天的计算机算法则是更加复杂的过程,由机器学习与计算智能领域开发,并翻译成机器语言。1950 年,该领域的先驱之一 Alan Turing 在“模仿游戏”中首次提出一个问题:如果机器能够思考,会怎样?[9] 他的理论是,如果机器能够模仿人类的交流,就可以被视为同样智能。当时,这只是一个思想实验;如今,视角不同,它几乎已经成为现实。普通用户已经无法区分机器输入与人类输入。数据新闻——从统计数据半自动生成文本——已经接管了记者简单的文字生产常规。社会的许多领域都能看到这种“算法转向”。尽管我们并非完全由技术决定,但我们显然生活在一个强烈受计算性算法技术驱动的世界里。这种发展,在社交媒体领域体现得最清楚。社交媒体生产者起初只有模糊想法和不完善的商业模式,如今却占据了互联网很大一部分,影响着我们对于什么是信息、以及信息应如何分发的定义。
计算过程通过算法执行。搜索引擎使用的算法仍然是一张指令列表,但并不如“非此即彼”的规则那般严格;多数时候,它们属于智能算法,也就是会随时间学习和改变的算法。作者们通常倾向于把算法问题表述 为控制问题:谁控制什么、控制谁?这是一个经典的主权问题,会引入层级的观念。以这种方式理解,算法可能很可怕:它们监视、治理、控制。从权力体制视角探索算法及 Google 搜索算法,有价值,也有启发;但我们想强调算法日常生活的另一面,即“找到”意味着什么:发现某个可能被搜寻过、也可能未被搜寻过的东西。搜索与找到需要彼此;它们走到一起,在数字沙滩上筑起城堡,层层叠叠地建立新构形与算法词语塔。我们发现,算法能够说出同时既旧又新的东西,总是几乎重复过去,却又从未完全回返。快进。倒带。Google 的自动补全搜索算法,是另一种搜索与找到、重新想象、创造和玩弄当下已有之物与未来之物的方式。换言之,自动补全激发并促进想象、创造力与嬉闹。
#whatalgorithmsdo(算法做什么)
算法凭借其基于规则的简单性,开启一个空间、地点与时间,让新与旧得以在令人敬畏的魔法万花筒中,同时、非线性地重做。正如 Waldrop 的优美概括:
当我们开始理解复杂系统,也开始理解自己是一个不断变化、相互咬合、非线性、万花筒般的世界的一部分。[…] 元素始终相同,却始终在重新排列自己。所以,它像一个万花筒:世界由变化着[并且具有连续性]的模式构成,这些模式部分重复,却从不完全重复,始终新鲜、始终不同。[10]
重复与重排,穿线与编织,为网络钩织出奇诡的结绳世界。搜索与再搜索。重新找到,与拆解后的再找到。新与旧。一起生长、变化,又不变化。当下 Google 之国中,不变、恒定而又多样的模式。过去成为未来之未来,一次又一次又一次。再来。重复。算法“活态”搜索引擎的动态,确保了模式性的重复,也确保了世界不断变形。
输入、存储、处理和输出,是算法的功能;这就是它们(目前)能做的一切。我们拥抱算法及其基于规则的对数;它们是简单的。如果你是算法,就没有歧义。你必须确切知道,将执行哪一步、哪一种功能、哪一个动作。另一方面,人类带来歧义、模糊和混乱。毫无歧义的算法世界,与孤独的冲浪者结合:后者不断从一个念头跳到另一个念头,把路径弄乱,为后来者铺下新石,扬起尘土,伪装成现在,倍增未来,再点击出一个新的、正在涌现的当下。在舞会上乔装打扮,像丑角小丑一样,抛接超链接与网络边缘,时时刻刻加工又抹去时间。[11]
这不只是乐趣与游戏。算法具有社会影响。Donald Knuth、[12] Thomas Corman 等人、[13] Steven Skiena[14] 以及许多作者,都表明算法与社会之间的关系很复杂。不过,也只是“有点”复杂。对社会进行排序和搜索,有太多方式。聚类与分类。机器学习模式。把这件东西与那件分开,分进分出。这个盒子,而不是那个盒子。和那些一起,不和这些一起。给难以排序的东西排序。搜索算法“黑箱”背后,是为了搜索而必须先整理的需要。的确,搜索算法大多归结为:我们怎样测量和界定差异与相似、距离与邻近,怎样测出某个东西是“远”还是“近”。扩大尺度,缩小尺度。把无序排出次序。始终如此,无处不在。这个,或那个。简言之,排序关乎匹配与排名。两个项目彼此匹配,再按排好的(无)序呈现。
#diggingintothealgorithm(深入挖掘算法)
为了进一步挖掘 Google 的自动补全算法,我们截取画面,并将它们与引文结合。我们把合写的邮件与网络搜索接在一起。来来回回,两人都在搜索那搜索。拼合不连贯之物。反思过程与(语境中的)文本。追踪与跟踪,抓取与剪辑。在丹麦与英国。数据体现了所采用的自我民族志路径。参与并观察。沉浸。记笔记。备忘。评论。迷失,再回来。为了思考、反思与写作。把互联网理解为考古发掘的地点。利用互联网,挖穿自动补全的链接。
>start [enter](开始[回车])
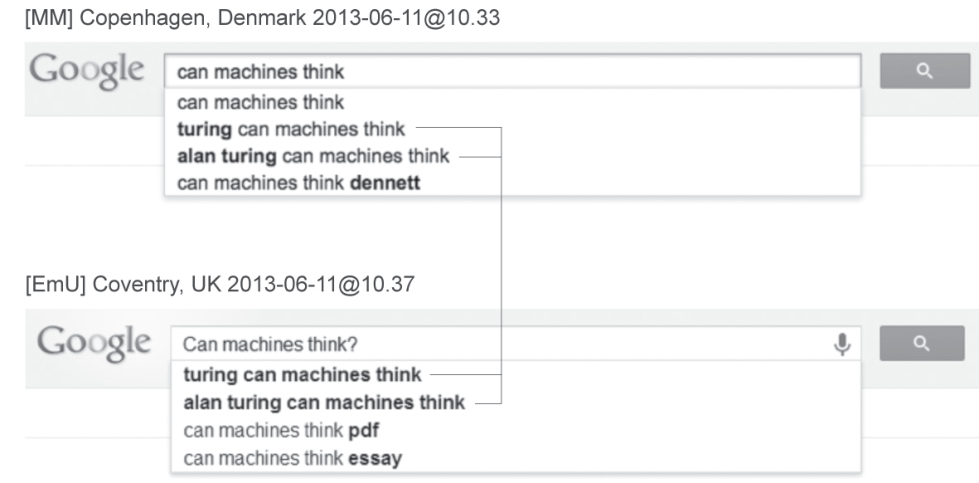
图中文字中文对照(中文版编排)
[MM] Copenhagen, Denmark 2013-06-11@10.33:[MM] 丹麦哥本哈根 2013-06-11@10.33
[EmU] Coventry, UK 2013-06-11@10.37:[EmU] 英国考文垂 2013-06-11@10.37
can machines think:机器能思考吗
Can machines think?:机器能思考吗?
turing can machines think:图灵 机器能思考吗
alan turing can machines think:艾伦·图灵 机器能思考吗
can machines think dennett:机器能思考吗 丹尼特
can machines think pdf:机器能思考吗 pdf
can machines think essay:机器能思考吗 论文
#thinkingmachines(思考的机器)
人与机器有何不同?真的不同吗?Daniel Dennett[手气不错,回车]认为:“那是一种特殊的内在光芒,一种只属于你、他人无法共享的私人方式,某种永远超出计算机科学边界的东西。”[15] Boden 在 1985 年指出:“人工智能(AI)构想于 20 世纪 40 年代中期 […]。此后,它取得了一些引人注目的成功,使计算机能够完成通常由心智完成的某些任务,尽管方式十分有限。”[16] 到头来,AI 不过是个模仿者,复制已有之物吗?试图达到原作,却永远差一点?
从图 2 可见,在丹麦与英国,用日常随意的方式快速输入“Can machines think?”(机器能思考吗?),不在意大小写和问号,会得到略有相似、但仍不同的自动补全词语。不过,图 3(见原书第 263 页)显示,自动补全词语不仅跨国家而不同,也随时间变化。换句话说,同样的搜索词只相隔 11 分钟使用,就显露出不同的一组词,有些相同,有些新增。相比之下,同样的搜索词相隔两天使用,却没有可见变化。这些结果固然引发担忧,也触发一整套其他可能反应。的确,我们很容易立刻质疑算法的审查和治理行为,因为它们划定并决定了搜索结果。我们想提出:恰恰是在 Google 自动补全的相似与差异中,我们获得了既与 Google 一起、又与它对着干的不同“玩法”。而且,正是通过让这些异同的可供性显现出来,Google 自动补全算法既成为一个场所,也成为一种机制;在其中,想象、创造力与嬉闹产生可接近性。
#imagination(想象)
想象是一种观看、认识和学习的方式;它要求我们超越理所当然。[17] 想象以开放为前提,建立在已知之上。想象栖身于“知觉、记忆、观念生成、情绪、隐喻,以及无疑还有生活中其他被命名的特征,相互交叉、相互作用的地方”。[18] 收集的数据表明,实际词语列表会随时间和空间变化。这些异同,既重要又不重要,只是呼应 Google 关于相关性的观念,试图感知并预测人机之间数字海洋的虚拟波浪。如今,想象一个没有 Google 的世界,就如同回忆一个没有计算机的世界:那都不是我们生活的世界。可以确定的是,未来总会有别的东西接替 Google。但此刻,我们的搜索以 Google 的印记开始,也以它结束。
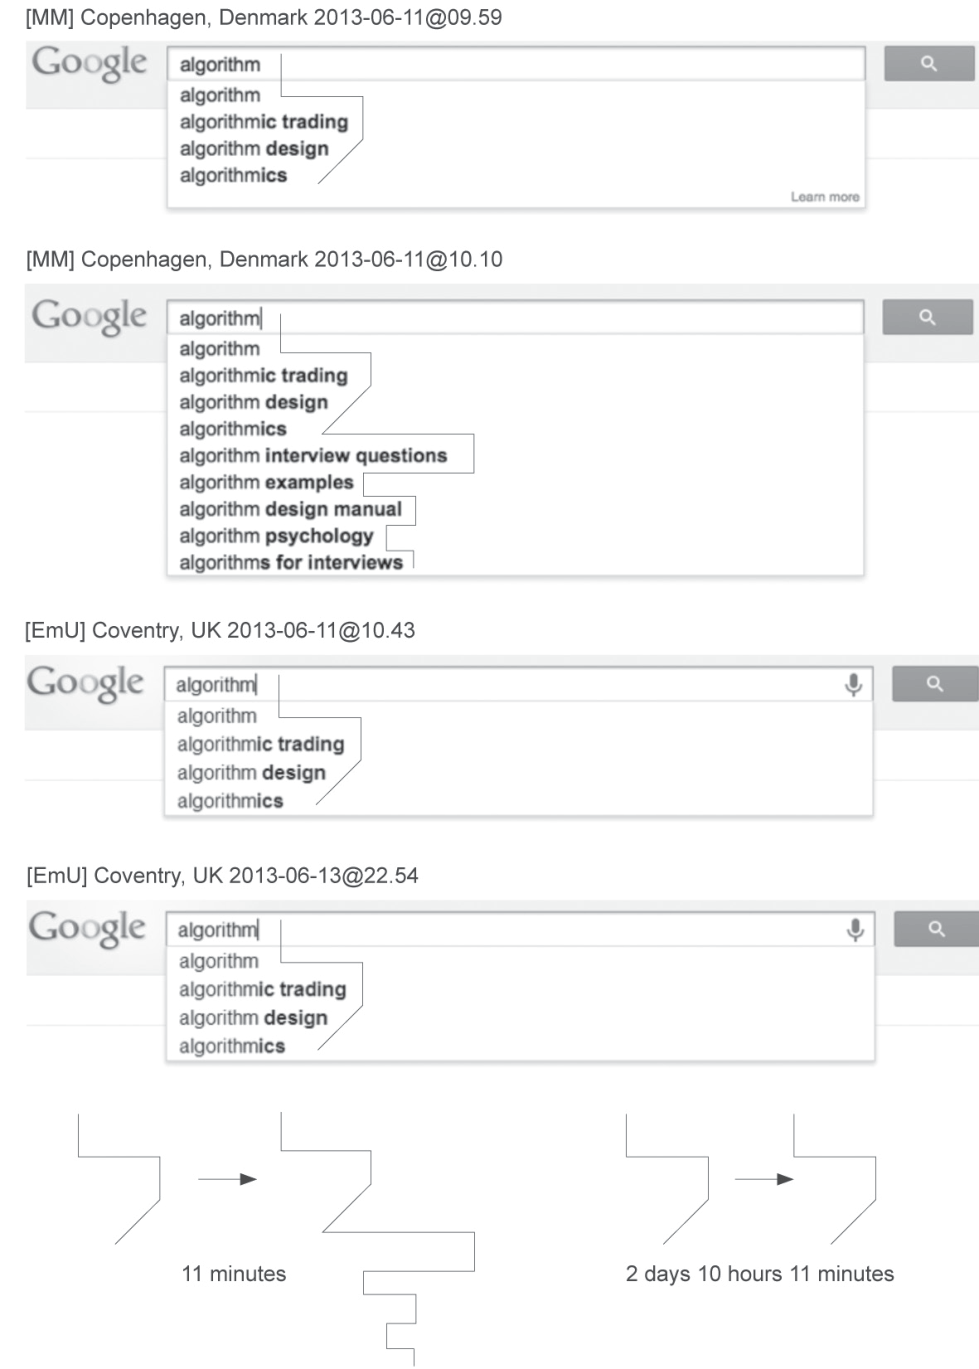
图中文字中文对照(中文版编排)
[MM] Copenhagen, Denmark 2013-06-11@09.59:[MM] 丹麦哥本哈根 2013-06-11@09.59
[MM] Copenhagen, Denmark 2013-06-11@10.10:[MM] 丹麦哥本哈根 2013-06-11@10.10
[EmU] Coventry, UK 2013-06-11@10.43:[EmU] 英国考文垂 2013-06-11@10.43
[EmU] Coventry, UK 2013-06-13@22.54:[EmU] 英国考文垂 2013-06-13@22.54
11 minutes:11 分钟
2 days 10 hours 11 minutes:2 天 10 小时 11 分钟
algorithm:算法
algorithmic trading:算法交易
algorithm design:算法设计
algorithmics:算法学
algorithm interview questions:算法面试题
algorithm examples:算法示例
algorithm design manual:算法设计手册
algorithm psychology:算法 心理学
algorithms for interviews:面试算法题
Learn more:了解更多
译注:图中英国组两次截图的时间戳为 2013 年 6 月 11 日 10:43 和 6 月 13 日 22:54,相差 2 天 12 小时 11 分钟;原图下方却标作“2 天 10 小时 11 分钟”。图中文字按原图保留。
图中文字中文对照(中文版编排)
[MM] Copenhagen, Denmark 2013-06-11@10.11:[MM] 丹麦哥本哈根 2013-06-11@10.11
[MM] Copenhagen, Denmark 2013-06-11@10.14:[MM] 丹麦哥本哈根 2013-06-11@10.14
[MM] Copenhagen, Denmark 2013-06-11@10.16:[MM] 丹麦哥本哈根 2013-06-11@10.16
[EmU] Coventry, UK 2013-06-11@13.24:[EmU] 英国考文垂 2013-06-11@13.24
[EmU] Coventry, UK 11.06.13@13.35:[EmU] 英国考文垂 11.06.13@13.35
[EmU] Coventry, UK 2013-06-11@13.37:[EmU] 英国考文垂 2013-06-11@13.37
[EmU] Coventry, UK 2013-06-11@13.45:[EmU] 英国考文垂 2013-06-11@13.45
algorith:algorith(未完成输入)
algori:algori(未完成输入)
algo:algo(未完成输入)
algorithmics inc:Algorithmics 公司
algorithmics the spirit of computing:算法学:计算的精神
www.algorithmics.com
algorithmics definition:算法学 定义
algorithmics ibm acquisition:Algorithmics IBM 收购
algorithmics book:算法学 书
algorithmics collateral:Algorithmics 抵押品
algorithmics fitch:Algorithmics 惠誉
algoriddim
algoritam
algoritmo
algonquin:阿尔冈昆
algonquin – Algonquin Hotel:阿尔冈昆-阿尔冈昆酒店
algonquin – Algonquin Regional:阿尔冈昆-阿尔冈昆地区
algonquin – Village in Illinois:阿尔冈昆-伊利诺伊州的村庄
algonquin commons:阿尔冈昆公共广场
algonquin round table:阿尔冈昆圆桌
algo me gusta de ti:我喜欢你的某一点
algonquin library:阿尔冈昆图书馆
algonquin college:阿尔冈昆学院
algonquin park:阿尔冈昆公园
algorithm:算法
algorithmic trading:算法交易
algorithm design:算法设计
algorithmics:算法学
algorithm interview questions:算法面试题
algorithm examples:算法示例
algorithm design manual:算法设计手册
algorithm psychology:算法 心理学
algorithms for interviews:面试算法题
第 1 行左|[MM] 丹麦哥本哈根|2013-06-11@10.11|输入:algorithmics
algorithmics:算法学
algorithmics inc:Algorithmics 公司
algorithmics the spirit of computing:算法学:计算的精神
www.algorithmics.com
algorithmics definition:算法学 定义
algorithmics ibm acquisition:Algorithmics IBM 收购
algorithmics book:算法学 书
algorithmics collateral:Algorithmics 抵押品
algorithmics fitch:Algorithmics 惠誉
第 1 行右|[EmU] 英国考文垂|2013-06-11@13.24|输入:algorithmics
algorithmics:算法学
algorithmics inc:Algorithmics 公司
algorithmics the spirit of computing:算法学:计算的精神
www.algorithmics.com
algorithmics definition:算法学 定义
algorithmics ibm acquisition:Algorithmics IBM 收购
algorithmics book:算法学 书
algorithmics collateral:Algorithmics 抵押品
algorithmics fitch:Algorithmics 惠誉
第 2 行左|[MM] 丹麦哥本哈根|2013-06-11@10.14|输入:algorith
algorithm:算法
algorithmic trading:算法交易
algorithm design:算法设计
algorithmics:算法学
algorithm interview questions:算法面试题
algorithm examples:算法示例
algorithm design manual:算法设计手册
algorithm psychology:算法 心理学
algorithms for interviews:面试算法题
第 2 行右|[EmU] 英国考文垂|11.06.13@13.35|输入:algorith
algorithm:算法
algorithmic trading:算法交易
algorithm design:算法设计
algorithmics:算法学
algorithm interview questions:算法面试题
algorithm examples:算法示例
algorithm design manual:算法设计手册
algorithm psychology:算法 心理学
algorithms for interviews:面试算法题
第 3 行左|[MM] 丹麦哥本哈根|2013-06-11@10.14|输入:algori
algorithm:算法
algorithmic trading:算法交易
algorithm design:算法设计
algoriddim
algorithmics:算法学
algorithm interview questions:算法面试题
algorithm examples:算法示例
algorithm design manual:算法设计手册
algorithm psychology:算法 心理学
第 3 行右|[EmU] 英国考文垂|2013-06-11@13.37|输入:algori;框内另以灰色显示 thm
algorithm:算法
algoritam
algorithmic trading:算法交易
algoritmo
第 4 行左|[MM] 丹麦哥本哈根|2013-06-11@10.16|输入:algo
algorithm:算法
algonquin:阿尔冈昆
algonquin – Algonquin Hotel:阿尔冈昆-阿尔冈昆酒店
algonquin – Algonquin Regional:阿尔冈昆-阿尔冈昆地区
algonquin – Village in Illinois:阿尔冈昆-伊利诺伊州的村庄
algonquin commons:阿尔冈昆公共广场
algonquin round table:阿尔冈昆圆桌
algo me gusta de ti:我喜欢你的某一点
algonquin library:阿尔冈昆图书馆
algorithmic trading:算法交易
第 4 行右|[EmU] 英国考文垂|2013-06-11@13.45|输入:algo
algonquin college:阿尔冈昆学院
algorithm:算法
algonquin:阿尔冈昆
algonquin park:阿尔冈昆公园
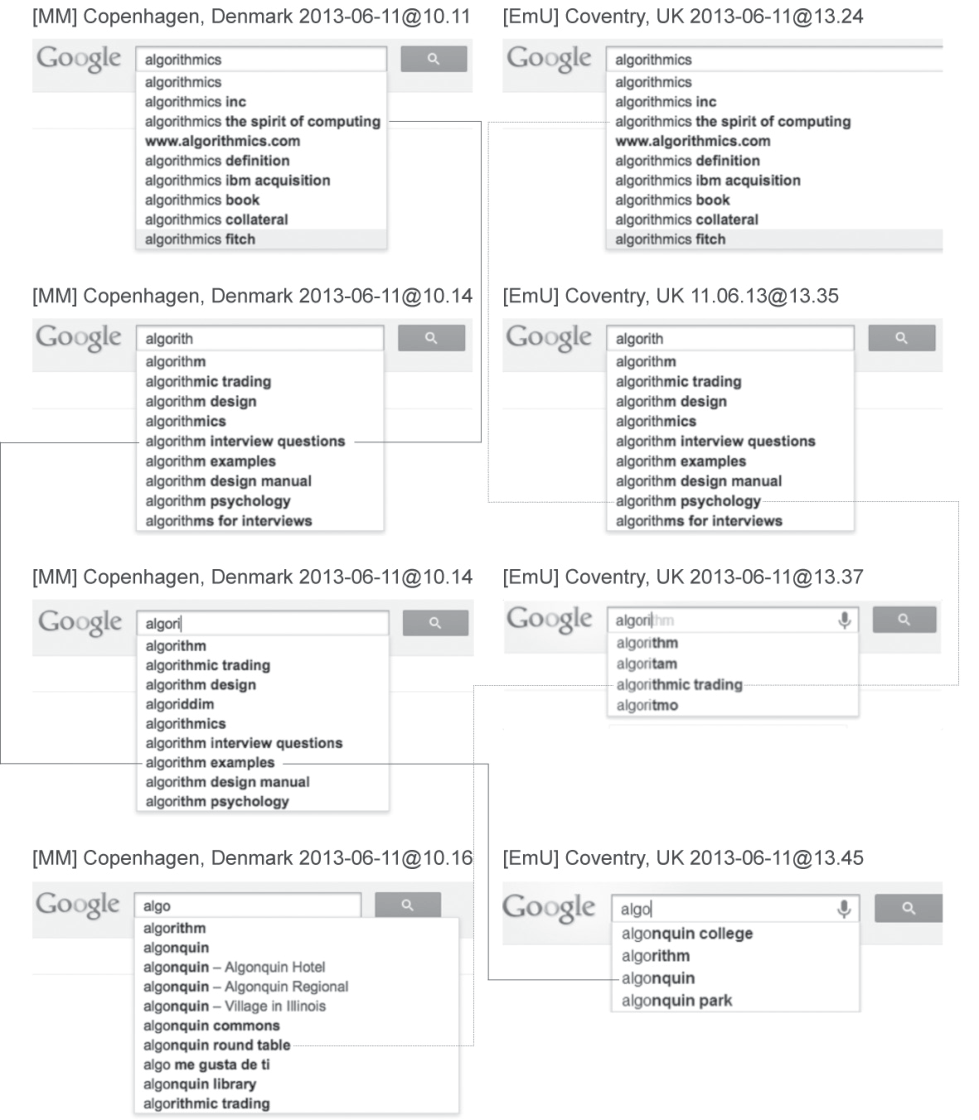
图 4 共有两列、四行、八个面板。以下按逐行先左后右的次序列出每个面板的自动补全建议;保留原输入、各面板中的重复词、建议的先后顺序,以及原图混用的日期格式。
原图用实线、虚线及跨列连线连接若干建议词,呈现作者所构造的“想象树”;中文对照不把各面板合并成去重后的词表。
>end [stop](结束[停止])
例如,在图 4(见原书第 264 页)中,Google 自动补全算法为我们开启了一个新的、富于想象的故事:输入“algo”时,我们想的是 algorithm(算法),它却把我们引向“algonquin”——一家酒店。自动补全让我们得以看见、使用、重新发明。我们也许会开始培育一棵“想象树”。如果创造性地使用和重新想象 Google 自动补全给出的词语,便可能长出无数故事;如果 Google 一开始没有给我们一些词来玩,这些故事也许永远不会被想象出来。
但是,是的,Google 也审查未被搜索的东西。不过,我们永远不知道自己无法知道什么,这不可避免。因此,算法确实有能力强化我们已知的东西;这也可能意味着强化负面话语。例如,Baker 和 Potts 提出,可见的自动补全词语强化了种族主义、恐同和性别歧视的刻板印象。[19] 然而,想象也许有助于平衡这一点,让我们发现先前未曾考虑过的词语世界的金块。搜索引擎怎么知道,我们不知道、也可能不想知道什么?在我们的数据材料中,Google 英国版往往显示比丹麦版更少的词。这真是 Google 的缘故吗?还是因为查询基于个人搜索,而与我们自己的搜索行为有关?这些真是“缺失”的词吗?它们真的被隐藏了吗?还是只在别处可见?那我们怎样找到它们?从来没有人问过吗?没有人在乎吗?讽刺的是,为了回答这些问题,我们又一次被拉入 Google 的谜团。我们搜索答案,Google 却把我们困住。为了找到搜索的答案而搜索那搜索,使我们再度卷入一场几乎无尽的追寻,寻找那些我们从未搜索过的问题的答案。不过,这样的搜索也让我们保持创造的感觉。
#creativity(创造力)
创造力是过程。创造力构成事物。创造性地看待 Google 自动补全,可以帮助我们以新方式学习和思考。我们经由 Google 形成的念头,其初始条件随时间与空间而变化,取决于哪些词浮到顶端(图 3)。正如 Alexander 所说,“问题的模式,与设计出回应这一问题的物理形式的过程之间,存在深刻而重要的底层结构对应”。[20] 这里也是如此:Google 自动补全算法的底层结构,呈现其自身的形式问题。也就是说,算法的物理形式,部分存在于其效果之中。反过来,这些效果又塑造算法,就像雕塑者不断改变手中黏土的形状,二者总是在辩证关系中一起变形;但雕塑者总比黏土多一点控制力,黏土只有经由雕塑者的手才获得生气。Google 搜索让我们找到想找的东西,但这些发现也受到一条极度不规则曲线的塑造,这条曲线不断被不可预测的词语列表扭转。
因此,我们也有潜能将众包能力发挥到最大,以有利于我们的方式塑造 Google 自动补全。例如,如果大家集体停止使用 Google,仅仅一天,会怎样?又或者,如果数十亿用户同时搜索 “capitalism needs to change”(资本主义需要改变)或“racism must be punished”(种族主义必须受到惩罚),会怎样?Google 自动补全算法内置的递归性,显然对时间和空间敏感;考虑到这一点,我们或许能够为改变规范性态度做得更多,只是尚未意识到。为共同善而集体行动的能力,也许就在于主动以类似社会运动的方式,与 Google 自动补全互动。如果 Google 能塑造我们的看法,也许我们能利用 Google 改变我们的看法?
#frivolity(嬉闹)
嬉闹被视为一种无害、不产生效益的活动,存在于结构更明确的游戏活动之外。Huizinga(1950)在《游戏的人》中指出,游戏是“一种自由活动,自觉地以不严肃的姿态立于‘日常’生活之外,却又同时强烈、彻底地吸引玩家”。而嬉闹则更短暂,通常没有规则或秩序。[21]
在《轻浮的考古学》中,Jacques Derrida 提出,嬉闹总被看作“坏的”“危险的”,而我们可以用它扰动并解构那些理所当然的看法。[22] 我们想强调的关键点之一,的确是:搜索算法需要被仔细观看,也需要被照看。我们必须确保自己知道,是谁在观看,又是谁在照看。但我们想强调,尽管搜索算法一旦被生产、投入行动、成为行动对象后,往往就像获得了自己的生命,它们与任何其他社会建构并无不同。赋予它们的权力,以及人们认为它们获得的独立性,都由社会建构。它们的权力被使之“成立”,其方式与统计显著性度量被使之成立相似:正如 Desrosières 在精彩的《大数的政治》中论证的,社会实践与制度不断重新确立这些度量。[23] 事实上,我们甚至认为,搜索算法与科学对象一样,都是建构物。正如 Collins 和 Pinch 在经典著作《魔像:关于科学你应该知道什么》中指出的,[24] 并不是科学本身“好”或“坏”;能够判断好坏的,是以“科学”之名对世界、并在世界中做了什么。
也许,正如我们始终提出的,尽管 Google 搜索算法有权力,有问题的并不是算法本身;有问题的或许是我们作为个人、或集体以政府形式,可能用 Google 做(或不做)的事情,以及我们没有做的事情。按照 Collins 和 Pinch 的逻辑,自动补全算法本身可以被看作一个魔像:一种神话生物。有点笨。傻乎乎。爱玩。不好也不坏。只是搜索。等待指令,告诉它搜什么。 因此,我们建议,可以把 Google 搜索算法用于嬉闹,扰乱那些铭刻并塑造我们世界的日常词语。利用 Google 自动补全来抵抗、来混淆。毕竟,每一次“搜索”,都需要一次“找到”,才能发现可能被搜索过、也可能未曾被搜索过的东西。搜索与找到需要彼此。[25] 沿着超链接浏览、大笑,因为发现、揭开和重获新空间、新世界、意外之物的喜悦而咯咯发笑。嬉闹地使用 Google,编出新的算法寓言、新的故事、新的未来。每日,平凡地。抛接超链接与自动纠错。日常。每一天。带着微笑,以嬉闹、创造力与想象的节奏,“驯服算法这只老虎”。
#lessonstolearn(可以学到什么)
“Ceci n’est pas une pipe”——“这不是一只烟斗”。Magritte 告诉我们,事物不总是其表面模样。我们生活在这样一个世界:一方面高度依赖信息,另一方面又无法再用亲身经验验证它。因此,我们通过 Google 自动补全算法等各种中介收集信息。在印刷时代,这些中介似乎明确,而且多少可以理解;如今却不再如此。面对现实吧:互联网——曾被认为是一个自由的信息空间——已经变得相当混乱。数字技术与机器智能领域持续创新,为日常信息混乱提供算法答案。算法背后的概念并不易懂,尤其当企业要依靠算法的秘密性维持经营时。这种局面带来了关于用户究竟收到什么信息的焦虑。最常见的担忧是:当算法依据一套无人知晓的规则计算信息流时,信息就会变得片面。我们不认为结果必然如此:搜索算法并非只基于算法本身,也基于我们这些用户,以及我们的搜索与找到行为。让我们开始接受这一状态,不再缴械投降。
搜索那搜索,就是寻找差异与相似、变化与停滞,始终在时间与空间中进行。算法会学习、会改变、会重复,也会保持不变。搜索算法进行治理,而且是可见地不可见;这些我们已经知道。我们已经做过、也需要继续做的,是创造性地玩。Google 给我们的,是玩耍的机会。如果不管做什么,我们总得到相同结果,世界该多无聊?这其实给了我们主动行动的机会。我们并不是撞上一堵无论如何都保持原样的墙。再见,Google 版《楚门的世界》!如果把算法理解为镜子,我们就可以主动承担责任,创造自己的镜像。此前,我们从未有过这样的机会,从未成为过这种“获得能力的公民”。让我们停止用某种神话般的规范标准衡量 Google,开始思考怎样创造性地使用它。
还有一点很重要:我们不能忽视搜索的乐趣、欢欣与游戏性。毕竟,搜索具有二重性。搜索让我们理解世界,以及世界中的自己。搜索是动词。“搜索”意味着“搜索者”对自己寻找的东西已经知道一些。的确,我们可以说:
搜索 = 保持好奇。
= 寻找答案。
= 寻找未知。
= 找到。
= 找到已知。
= 找到未知。
= 找到问题。
= 感到困惑。
= 感到意外。
= 不感到意外。
= 在不同时间、同一地点进行的社会实践。
= 在同一时间、不同地点进行的社会实践。
= 在不同时间、不同地点找到相同之物的社会实践。
= 搜索搜索,并找到搜索。
= 惊喜盒,总是又从不让人意外,可以预料地不可预料。
#thestorybehind(背后的故事)
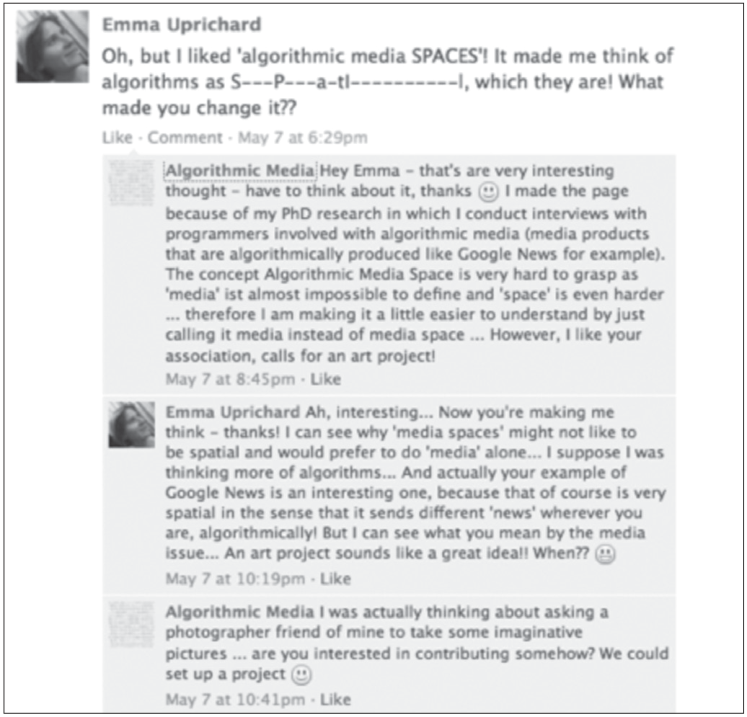
故事始于 2013 年 5 月的 Facebook。Martina(第一作者)新建了一个 Facebook 页面,邀请朋友们“点赞”。Emma(第二作者)收到这样的邀请,不是来自 Martina——两位作者当时还不认识——而是来自她的另一位 Facebook 朋友。邀请请她给一个名为“Algorithmic Media Spaces”(算法媒体空间)的页面点赞,但第二天,Emma 发现页面名称改成了“Algorithmic Media”(算法媒体)。她以为是那位朋友建立了页面,便发了一条傻乎乎的消息,询问为何更名(图 5)。“Algorithmic Media”,也就是 Martina,回复并作了解释。
图中文字中文对照(中文版编排)
Emma Uprichard
Algorithmic Media:算法媒体
Oh, but I liked 'algorithmic media SPACES'! It made me think of algorithms as S---P---a-tI-----------l, which they are! What made you change it??:噢,可我喜欢“算法媒体空间”!它让我想到算法是空——间——性——的,而它们确实如此!是什么让你改了名字??
Hey Emma – that's are very interesting thought – have to think about it, thanks ☺ I made the page because of my PhD research in which I conduct interviews with programmers involved with algorithmic media (media products that are algorithmically produced like Google News for example). The concept Algorithmic Media Space is very hard to grasp as 'media' ist almost impossible to define and 'space' is even harder ... therefore I am making it a little easier to understand by just calling it media instead of media space ... However, I like your association, calls for an art project!:嗨,Emma——这是个非常有趣的想法——我得想一想,谢谢 ☺ 我建立这个页面,是因为我的博士研究会采访从事算法媒体的程序员,也就是通过算法生产的媒体产品,例如 Google News。“算法媒体空间”这个概念很难把握,因为“媒体”几乎无法定义,“空间”就更难了……所以,为了让它稍微容易理解,我只称它为媒体,而不是媒体空间……不过,我喜欢你的联想,它值得成为一个艺术项目!
Ah, interesting... Now you're making me think – thanks! I can see why 'media spaces' might not like to be spatial and would prefer to do 'media' alone... I suppose I was thinking more of algorithms... And actually your example of Google News is an interesting one, because that of course is very spatial in the sense that it sends different 'news' wherever you are, algorithmically! But I can see what you mean by the media issue... An art project sounds like a great idea!! When?? ☺:啊,有意思……现在你也让我思考了——谢谢!我明白了,“媒体空间”为什么可能不喜欢具有空间性,而宁愿只做“媒体”……我想,我更多考虑的是算法……其实你举的 Google News 很有意思,因为它当然很有空间性:你在哪里,它就用算法发送不同的“新闻”!不过,我能理解你说的媒体问题……艺术项目听上去是个好主意!!什么时候?? ☺
I was actually thinking about asking a photographer friend of mine to take some imaginative pictures ... are you interested in contributing somehow? We could set up a project ☺:其实,我正在考虑请一位摄影师朋友拍一些富于想象的照片……你有兴趣以某种方式参与吗?我们可以一起做个项目 ☺
Like · Comment · May 7 at 6:29pm:赞 · 评论 · 5 月 7 日下午 6:29
May 7 at 8:45pm · Like:5 月 7 日下午 8:45 · 赞
May 7 at 10:19pm · Like:5 月 7 日下午 10:19 · 赞
May 7 at 10:41pm · Like:5 月 7 日下午 10:41 · 赞
Emma 首条留言刻意拉开 spatial(空间性的)的字母间距。由于原截图清晰度有限,这一拉伸字形的英文转录仅近似呈现连字符数量与大小写;中文以“空——间——性——的”保留其表达方式,确切字形以原图为准。
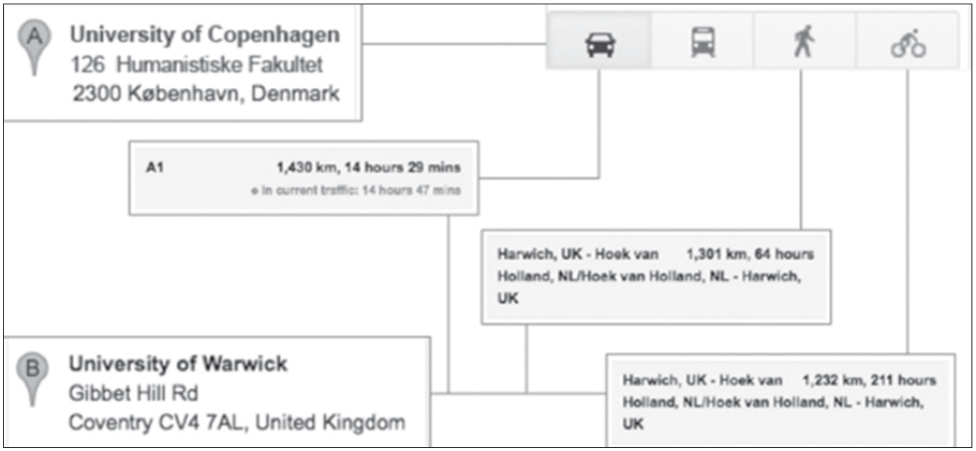
算法就是这样把我们带到一起,正如它们把世界中的许多东西带到一起;每天,跨越时间与空间(图 6)。
图中文字中文对照(中文版编排)
University of Copenhagen:哥本哈根大学
126 Humanistiske Fakultet:126 人文学院
2300 København, Denmark:丹麦哥本哈根,2300
University of Warwick:华威大学
Gibbet Hill Rd:Gibbet Hill 路
Coventry CV4 7AL, United Kingdom:英国考文垂 CV4 7AL
A1
1,430 km, 14 hours 29 mins:1,430 千米,14 小时 29 分钟
In current traffic: 14 hours 47 mins:按当前路况:14 小时 47 分钟
Harwich, UK - Hoek van Holland, NL/Hoek van Holland, NL - Harwich, UK:英国哈里奇-荷兰荷兰角/荷兰荷兰角-英国哈里奇
1,301 km, 64 hours:1,301 千米,64 小时
1,232 km, 211 hours:1,232 千米,211 小时
端点 A 是 University of Copenhagen(哥本哈根大学),位于左上;端点 B 是 University of Warwick(华威大学),位于左下。右上方四个交通方式图标从左到右为汽车、列车、步行、自行车。
三个路线信息框以灰色直角折线连接:上框为 A1,1,430 千米、14 小时 29 分钟,按当前路况为 14 小时 47 分钟;中框为 1,301 千米、64 小时;下框为 1,232 千米、211 小时。中、下框均显示英国哈里奇与荷兰荷兰角之间的往返线路文字。位置、图标与折线关系按原图保留;最下方信息框在底本中被裁切,不补写未显示的延续内容。
#thanks(致谢)
感谢 Philipp Lenssen(http://outer-court.com)慷慨允许我们在 #searching 一节使用他的图像。我们将它题为“我 Google,故我在”,这不是原图标题。还要感谢 Miriam Rasch 和 René König 的编辑工作。
#references(参考文献)
Alexander, Christopher. Note on the Synthesis of Form, Cambridge, MA: Harvard University Press, 1964.
Baker, Paul and Amanda Potts. ‘“Why do white people have thin lips?” Google and the Perpetuation of Stereotypes via Auto-Complete Search Forms’, Critical Discourse Studies 10.2 (2013): 187-204.
Bates, Rodger A. and Emily Fortner. ‘The Social Construction of Frivolity’, The Journal of Professional and Public Sociology, 5.1 (2013), http://digitalcommons.kennesaw.edu/jpps/vol5/iss1/5.
Beer, David. ‘Power Through the Algorithm? Participatory Web Cultures and the Technological Unconscious’, New Media & Society 11 (September 2009): 985-1002.
Boden, Margaret A. ‘The Social Impact of Thinking Machines’ in Tom Forester (ed.) The Information Technology Revolution, Oxford: Basil Blackwell, 1985, pp. 95-103.
Bucher, Taina. ‘Want to Be on the Top? Algorithmic Power and the Threat of Invisibility on Facebook’, New Media & Society 14.7 (November 2012): 1164-1180.
Chabert, Jean-Luc. A History of Algorithms, Berlin, Heidelberg: Springer, 1999.
Collins, Harry and Trevor Pinch. The Golem: What You Should Know about Science, Cambridge, U.K.: Cambridge University Press, 1998.
Corman, Thomas H., Charles E. Leiserson, Ronald L. Rivest, and Clifford Stein. Introduction to Algorithms, Cambridge MA: MIT Press
Dennett, Daniel. ‘Can Machines Think?’ in Christof Teuscher (ed.) Alan Turing: Life and Legacy of a Great Thinker, Berlin: Springer, 2004
Derrida, Jacques. The Archeology of the Frivolous, trans. J. Leavey Jr., Pittsburg: Duquesne University Press, 1973.
Desrosières, Alain. The Politics of Large Numbers: A History of Statistical Reasoning, trans. Camille Naish, Cambridge, MA: Harvard University Press, 1998.
Egan, Kieran. Imagination in Teaching and Learning: The Middle School Years, Chicago: The University of Chicago Press, 1992.
Gillespie, Tarleton. ‘Can an Algorithm Be Wrong? Twitter Trends, the Specter of Censorship, and Our Faith in the Algorithms Around Us’, Culture Digitally blog, 19 October 2011, http://culture digitally.org/2011/10/can-an-algorithm-be-wrong/. [译注:原书域名中含空格,照录;这不是经过验证的有效链接。]
Knuth, Donald. Fundamental Algorithms, vol. 1 of The Art of Computer Programming, Boston: Addison-Wesley, 1997 (1968).
_____, Sorting and Searching, vol. 3 of The Art of Computer Programming, Boston: Addison-Wesley, 1993 (1973).
Lake, Robert. A Curriculum of Imagination in an Era of Standardization: An Imaginative Dialogue with Maxine Greene and Paulo Freire, Charlotte, NC: Information Age Pub, 2013.
Naughton, John. ‘How Algorithms Secretly Shape the Way We Behave’, The Guardian, 15 December 2012, http://www.guardian.co.uk/technology/2012/dec/16/networker-algorithms-john-naughton.
Pariser, Eli. The Filter Bubble: What the Internet is Hiding from You, London: Penguin Press, 2011.
Rieder, Bernhard. ‘Democratizing Search? From Critique to Society-oriented Design’, in Konrad Becker and Felix Stalder (eds) Deep Search. The Politics of Search beyond Google, Innsbruck: Studienverlag, 2009, pp. 133-151.
_____. ‘Networked Control: Search Engines and the Symmetry of Confidence’, International Review of Information Ethics 3.1 (2005): 26-32.
Skiena, Steven. The Algorithm Design Manual, London: Springer, 2008.
Slavin, Kevin. ‘How Algorithms Shape Our World’, TED Talks, July 2011 http://www.ted.com/talks/kevin_slavin_how_algorithms_shape_our_world.html.
Steiner, Christopher. Automate This: How Algorithms Came to Rule Our World, New York, NY: Portfolio/Penguin, 2012.
Turing, Alan. ‘Computing Machinery and Intelligence’, in Paul A. Meyer (ed.) Computer Media and Communication: A Reader, Oxford: Oxford University Press, 1999, p. 37-58.
Van Couvering, Elizabeth Jane. Search Engine Bias, PhD diss., Department Media and Communications, London School of Economics and Political Science, London, U.K., 2009.
Waldrop, M. Mitchell. Complexity: The Emerging Science at the Edge of Order and Chaos, New York: Simon and Schuster, 1992.